Cours#
Le Web : réseaux et interactions homme-machine
| Programme (BO) | Interactions homme-machine sur le Web : décomposer une URL ; distinguer ce qui relève du client et du serveur ; requêtes HTTP GET/POST ; réaliser et analyser une page HTML/CSS simple ; rôle de HTML, CSS, JavaScript ; événements et modification du document ; formulaires ; distinguer ce qui est mémorisé dans le client (cookies) et retransmis au serveur. Réseaux : notion de protocole, adresse IP, acheminement par paquets (routeurs, commutateurs), modèles client-serveur et pair-à-pair. |
| Prérequis | le chapitre Architecture des ordinateurs et systèmes d’exploitation (client/serveur \(=\) deux machines en réseau) ; savoir écrire une fonction. (→ fiches de révision : ch. 9) |
| Objectifs | comprendre ce qui se passe entre un clic et l’affichage d’une page ; lire une URL ; savoir ce qu’est un protocole, une adresse IP, un paquet ; distinguer client et serveur ; écrire une page HTML/CSS et la rendre interactive en JavaScript ; envoyer des données par un formulaire (GET/POST). |
Situation de départ
-
Que se passe-t-il entre le clic sur un lien et l’affichage de la page ?
-
Si un morceau d’une vidéo se perd en route, comment l’ordinateur qui l’a envoyé peut-il le savoir ?
-
Comment un site marchand se souvient-il de votre panier d’une page à l’autre ?
Remarque — Le fil conducteur : le voyage d’un clic
Vous tapez une adresse, vous appuyez sur Entrée, et en une fraction de seconde une page s’affiche. Que s’est-il passé ? Un voyage : votre navigateur (le client) a trouvé la bonne machine sur le réseau (via son adresse IP), lui a envoyé une requête HTTP découpée en paquets qui ont traversé des routeurs, le serveur a renvoyé des fichiers HTML/CSS/JavaScript, et le navigateur les a assemblés en une page avec laquelle vous interagissez. Ce chapitre suit ce voyage, de bout en bout. Les points qui dépassent le programme portent le badge au-delà du programme.
Internet et le Web : ne pas confondre#
Définition 1 — Internet et le Web
Internet est le réseau mondial : l’infrastructure de câbles, fibres, antennes et machines qui relient les ordinateurs entre eux. Le Web (World Wide Web) est l’un des services qui circulent sur Internet : l’ensemble des pages reliées par des liens hypertextes, consultées avec un navigateur.
Internet transporte bien d’autres choses que le Web : le courriel, les messageries, les jeux en ligne, le streaming… Confondre les deux, c’est confondre la route (Internet) et l’un des véhicules qui roulent dessus (le Web).
Le réseau : comment les machines se parlent#
Définition 2 — Protocole
Un protocole est un ensemble de règles précises que deux machines respectent pour communiquer. Comme deux personnes doivent parler la même langue et respecter des tours de parole, deux ordinateurs doivent suivre le même protocole pour se comprendre.
↺ Retour sur l'activité. La dernière question de l’activité « Le réseau qui perd des papiers » y répondait : les règles des manches 2 et 3, que l’émetteur et le récepteur devaient respecter tous les deux, formaient un protocole.
Définition 3 — Adresse IP
Pour être jointe sur le réseau, chaque machine possède une adresse IP (Internet Protocol), son « numéro » unique. En version IPv4, c’est une suite de quatre nombres de 0 à 255, par exemple 193.51.208.14. C’est l’équivalent d’une adresse postale : sans elle, impossible de livrer un message à la bonne machine.
Règle 1 — On voyage en paquets
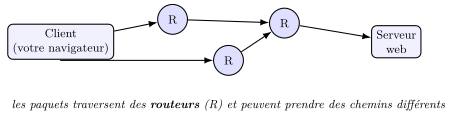
Un message (une page, un mail, une vidéo) n’est pas envoyé d’un bloc : il est découpé en petits morceaux, les paquets. Chaque paquet porte l’adresse IP de départ et d’arrivée, voyage indépendamment à travers le réseau, et les paquets sont réassemblés à l’arrivée. Si un paquet se perd, il est renvoyé.
Définition 4 — Routeur et commutateur
Un routeur est une machine qui aiguille les paquets : il lit l’adresse IP de destination et choisit vers quel voisin renvoyer le paquet pour le rapprocher du but (comme un centre de tri postal). Un commutateur (switch) relie les machines d’un même réseau local (une salle, une maison). L’ensemble des routeurs interconnectés forme Internet.
À retenir — Trouver l’adresse : le DNS
On ne retient pas des suites de chiffres : on tape www.lycee.mc, pas 193.51.208.14. Le DNS (Domain Name System) est l’annuaire du réseau : il traduit un nom de domaine en adresse IP. Première étape du voyage : le navigateur demande au DNS « quelle est l’IP de www.lycee.mc ? ».
Définition 5 — Client-serveur et pair-à-pair
Deux façons d’organiser les échanges :
-
client-serveur : des machines clientes demandent des ressources à une machine serveur qui les fournit (le modèle du Web) ;
-
pair-à-pair (peer-to-peer, P2P) : chaque machine est à la fois cliente et serveur, et échange directement avec les autres, sans passer par un serveur central (partage de fichiers, certaines messageries).
Ne perdre aucun paquet : l’accusé de réception et le bit alterné#
Un paquet perdu est renvoyé : encore faut-il que l’émetteur sache qu’il est perdu. Le récepteur doit donc répondre.
Définition 6 — Accusé de réception
Après avoir reçu un paquet, le récepteur renvoie un petit message de confirmation, l’accusé de réception (ACK, de acknowledgement). Tant que l’émetteur n’a pas reçu l’accusé au bout d’un certain délai, il considère le paquet perdu et le renvoie.
↺ Retour sur l'activité. Le papier « reçu » de la manche 2 était un accusé de réception, et les 10 secondes comptées par l’émetteur le délai au-delà duquel il renvoyait sa lettre.
Si c’est l’accusé qui se perd, l’émetteur renvoie un paquet déjà reçu : le récepteur doit pouvoir reconnaître ce doublon.
Règle 2 — Le protocole du bit alterné
On étiquette chaque paquet avec un seul bit, qui vaut alternativement 0, 1, 0, 1… L’accusé renvoie le numéro du paquet attendu ensuite. Les règles :
-
l’émetteur n’envoie le paquet suivant (avec le bit changé) que lorsqu’il a reçu l’accusé du paquet courant ;
-
sans accusé au bout du délai, il renvoie le même paquet, avec le même bit ;
-
si le récepteur reçoit un paquet portant le bit qu’il a déjà traité, c’est un doublon : il le jette mais renvoie quand même l’accusé.
Un seul bit suffit à distinguer « le nouveau paquet » de « le même, renvoyé ».
↺ Retour sur l'activité. Dans la manche 2, un papier « reçu » perdu faisait écrire BALLLON au récepteur, incapable de reconnaître le L renvoyé. Dans la manche 3, le chiffre 0 ou 1 de chaque papier lui permettait de jeter ce doublon : c’était le protocole du bit alterné.
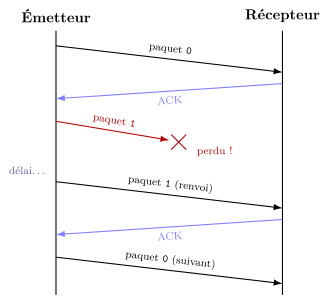
Le paquet 1 est perdu ; faute d’accusé, l’émetteur le renvoie à l’identique. Le bit permet au récepteur de ne pas confondre un renvoi avec un nouveau paquet.
Remarque
Ce mécanisme d’accusés et de renvois est au cœur du protocole TCP, qui garantit sur Internet qu’aucune donnée n’est perdue ni dupliquée ; le bit alterné en est la version la plus simple.
▶ Exercices d'application : exercices 1 à 5 (réseaux : Internet/Web, paquets, bit alterné)
Le modèle client-serveur et l’URL#
Sur le Web, votre navigateur est un client : il demande des pages à des serveurs web, des machines allumées en permanence dont le rôle est de servir des ressources. Pour désigner la ressource voulue, on utilise une URL.
Définition 7 — URL — Uniform Resource Locator
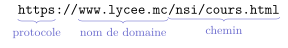
Une URL est l’adresse d’une ressource sur le Web. On la décompose :
-
https: le protocole utilisé (ici la version sécurisée de HTTP) ; -
www.lycee.mc: le nom de domaine du serveur (traduit en IP par le DNS) ; -
/nsi/cours.html: le chemin de la ressource sur le serveur.
À retenir — Reconnaître une page sécurisée
Quand l’URL commence par https (et non http), la communication est chiffrée : personne ne peut lire au passage ce qui circule. Réflexe : avant de saisir un mot de passe ou des coordonnées bancaires, vérifier le https. Le « s » veut dire secure. Attention : le https (le cadenas) prouve que la liaison est chiffrée, pas que le site est honnête ; un site d’hameçonnage peut lui aussi être en https, il faut donc aussi vérifier le nom de domaine. On étudiera le chiffrement en Terminale.
Pour les curieux (facultatif) — Le port
L’adresse IP désigne la machine ; le port (un numéro) désigne le service visé sur cette machine. Le Web utilise par convention le port 80 en http et le port 443 en https. C’est pourquoi on ne les écrit presque jamais dans l’URL : ils sont sous-entendus.
HTTP : la langue du Web#
Une fois le serveur trouvé, client et serveur dialoguent selon le protocole HTTP (HyperText Transfer Protocol) : le client envoie une requête, le serveur renvoie une réponse.
Règle 3 — Requête et réponse HTTP
Une requête contient notamment une méthode et le chemin de la ressource :
GET /nsi/cours.html HTTP/1.1
La réponse commence par un code de statut, suivi d’en-têtes (des métadonnées : type et taille du contenu, date…), puis d’une ligne vide et enfin du corps (la ressource elle-même) :
HTTP/1.1 200 OK
Content-Type: text/html; charset=utf-8
Content-Length: 1024
...
<!doctype html> ...le code HTML de la page...
Définition 8 — Les deux méthodes à connaître : GET et POST
-
GET: demander une ressource (le cas le plus courant : afficher une page). Les éventuels paramètres sont visibles dans l’URL. -
POST: envoyer des données au serveur pour qu’il les traite (typiquement, les données d’un formulaire). Les données ne sont pas dans l’URL.
À retenir — Quelques codes de statut
Le code résume ce qui s’est passé : 200 « OK, voici la ressource » ; 304 « pas modifiée, garde ta version en cache » (évite de re-télécharger un fichier inchangé) ; 404 « ressource introuvable » (la fameuse page d’erreur) ; 403 « accès interdit » ; 500 « erreur du serveur ». Les codes qui commencent par 2 sont des succès, par 3 des redirections ou du cache, par 4 des erreurs du client, par 5 des erreurs du serveur.
Règle 4 — Une page \(=\) souvent des dizaines de requêtes
Afficher une page « simple » ne demande presque jamais une seule ressource. Le navigateur reçoit d’abord le HTML, le lit, et y découvre des références vers d’autres fichiers (feuilles .css, scripts .js, images, polices…) : pour chacun il envoie une nouvelle requête HTTP. Une page riche déclenche ainsi facilement plusieurs dizaines d’échanges requête/réponse avant d’être complète.
Méthode — Observer les échanges : les outils de développement
Tous les navigateurs offrent des outils de développement (touche F12, onglet Réseau). On y voit en direct, pour chaque page, la liste des requêtes, leur méthode (GET…), leur code de statut (200, 304, 404…), leur taille et leur temps de chargement. C’est le meilleur moyen de voir concrètement le protocole HTTP à l’œuvre.
▶ Exercices d'application : exercices 6 à 9 et 27 (URL et HTTP)
HTML : structurer la page#
La ressource renvoyée est le plus souvent un fichier HTML (HyperText Markup Language). Ce n’est pas un langage de programmation : c’est un langage de balisage qui décrit la structure du contenu (titres, paragraphes, images, liens…).
Définition 9 — Balises
Le contenu est encadré par des balises : une balise ouvrante <p> et une balise fermante </p>. Certaines portent des attributs.
<!doctype html>
<html lang="fr">
  <head>
    <meta charset="utf-8">
    <title>Ma page</title>
    <link rel="stylesheet" href="style.css">
  </head>
  <body>
    <h1>Bienvenue en NSI</h1>
    <p>Ceci est un <strong>paragraphe</strong> important.</p>
    <a href="https://eduscol.education.fr">Un lien hypertexte</a>
    <img src="logo.png" alt="logo du lycee">
  </body>
</html>
-
<head>: les informations sur la page (titre, encodage, feuille de style) ;<body>: le contenu visible ; -
<h1>un titre,<p>un paragraphe,<strong>du texte important,<img>une image ; -
<a href="...">crée un lien hypertexte : c’est lui qui relie les pages entre elles et fait du Web une toile.
Remarque — D’autres balises courantes
Au-delà de l’exemple : les titres <h1> à <h6> (du plus au moins important) ; les listes <ul> (à puces) ou <ol> (numérotée), dont chaque élément est un <li> ; <br> un retour à la ligne ; <table> un tableau ; et les conteneurs <div> (en bloc) et <span> (en ligne) qui regroupent des éléments pour les mettre en forme ou les manipuler. Un commentaire, ignoré par le navigateur, s’écrit <!-- ... -->.
Remarque — Les balises « auto-fermantes »
Certaines balises n’entourent aucun contenu et n’ont pas de balise fermante : <img>, <br>, <meta>, <input>, <link>. On écrit <img src="logo.png"> et jamais <img>…</img>.
Définition 10 — Les attributs id et class
On peut « étiqueter » une balise pour la retrouver ensuite (en CSS ou en JavaScript) :
-
id="menu": un identifiant unique dans la page (une seule balise peut le porter) ; -
class="bouton": une étiquette partagée, que plusieurs balises peuvent avoir en commun (pour les traiter ensemble).
À retenir — Une page est un arbre : le DOM
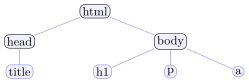
Les balises s’emboîtent sans se croiser : le document forme un arbre, appelé DOM (Document Object Model). C’est cet arbre que le navigateur construit en mémoire, et que le JavaScript pourra modifier.
▶ Exercices d'application : exercices 10 à 13 (balises ; lire, corriger, créer du HTML)
CSS : mettre en forme#
Le CSS (Cascading Style Sheets) décrit la présentation : couleurs, tailles, polices, dispositions. Principe fondamental : séparer le fond (HTML) de la forme (CSS). Le même contenu peut ainsi changer d’apparence sans qu’on touche au HTML.
Règle 5 — Une règle CSS
Une règle vise un sélecteur (quelles balises) et lui applique des propriétés, chacune sous la forme propriété: valeur; :
h1      { color: darkblue; text-align: center; }   /* toutes les balises h1 */
p       { font-size: 14px; line-height: 1.5; }     /* tous les paragraphes  */
#menu   { background-color: gold; }        /* l'unique balise id="menu"     */
.bouton { color: white; padding: 8px; }    /* toutes les balises class="bouton" */
Définition 11 — Les trois sélecteurs à connaître
-
par nom de balise (
h1,p) : vise toutes les balises de ce type ; -
par identifiant, préfixe
#(#menu) : vise l’unique baliseid="menu"; -
par classe, préfixe
.(.bouton) : vise toutes les balisesclass="bouton".
Remarque — Trois façons de brancher le CSS
Le plus propre : une feuille externe style.css reliée par <link rel="stylesheet" href="style.css"> (réutilisable sur tout le site). On peut aussi écrire le CSS dans le <head>, entre <style>…</style>, ou en ligne sur une balise via l’attribut style="…" — à réserver aux petits ajustements.
Remarque — Quelques propriétés utiles
color (couleur du texte), background-color (fond), font-size, font-family, text-align ; et pour l’espacement : margin (marge extérieure), padding (marge intérieure), border (bordure), width/height (dimensions). Les tailles s’expriment en px (pixels), % ou em.
Pour les curieux (facultatif) — Pourquoi « cascade » ?
Plusieurs règles peuvent viser la même balise. En cas de conflit, la plus spécifique l’emporte (un #id bat une .classe, qui bat un nom de balise) ; à spécificité égale, la dernière écrite gagne. Les styles « ruissellent » ainsi du général vers le particulier — d’où le nom Cascading Style Sheets.
Disposer les éléments : Flexbox#
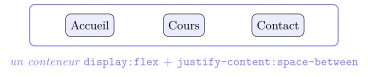
Par défaut, les blocs (<div>, <p>, <li>…) s’empilent verticalement, l’un sous l’autre. Pour les aligner horizontalement et les répartir proprement, on transforme leur conteneur en « boîte flexible » avec la propriété display: flex.
.barre {
    display: flex;              /* les enfants se placent en ligne */
    gap: 10px;                  /* espace entre eux */
    justify-content: center;    /* repartition horizontale */
    align-items: center;        /* alignement vertical */
}
Appliquée à un bloc <div class="barre">``…</div>, cette règle aligne tous ses enfants directs sur une même ligne. justify-content règle la répartition horizontale (center, space-between, flex-start…), align-items l’alignement vertical, et gap l’espace entre les éléments. C’est l’outil standard pour construire une barre de navigation ou disposer des cartes côte à côte.
▶ Exercices d'application : exercices 14 à 16 (CSS : relier une feuille, sélecteurs id/class, aligner avec Flexbox)
JavaScript : rendre la page interactive#
HTML structure, CSS met en forme… mais tout cela est figé. Le JavaScript (JS) est un vrai langage de programmation, exécuté dans le navigateur (côté client), qui rend la page vivante : réagir à un clic, modifier le contenu, valider un formulaire…
Règle 6 — Les trois langages du Web
HTML \(=\) le fond (structure) ; CSS \(=\) la forme (présentation) ; JavaScript \(=\) le comportement (interaction). Trois rôles distincts, une seule page.
Remarque — Un peu de syntaxe JavaScript
On déclare une variable avec let (ou const si sa valeur ne change jamais) ; une fonction s’écrit function nom() { …} ; les instructions se terminent par ; et un commentaire par //. C’est proche du Python, mais avec des accolades { } à la place de l’indentation.
Répondre à un événement#
Un événement est quelque chose qui se produit dans la page, le plus souvent une action de l’utilisateur : un clic (click), le survol de la souris (mouseover), une touche du clavier (keydown), la modification d’un champ (change), l’envoi d’un formulaire (submit), le chargement de la page (load)… On y réagit en exécutant une fonction JavaScript.
<p id="monPara">Voici une page qui ne fait pas grand-chose.</p>
<button onclick="changer()">Cliquer ici</button>
<script src="script.js"></script>
Remarque — Deux manières de brancher un événement
Rapide : un attribut on… directement dans le HTML, comme <button onclick="changer()">. Plus propre (le comportement reste séparé de la structure) : depuis le JavaScript, avec addEventListener. Le bouton porte alors un identifiant, et plus d’attribut onclick :
<button id="monBouton">Cliquer ici</button>
let bouton = document.querySelector("#monBouton");
bouton.addEventListener("click", changer);   // sans les parentheses
Modifier le document (le DOM)#
Dans script.js, on sélectionne un élément puis on le modifie :
function changer() {
    let maBalise = document.querySelector("#monPara");
    maBalise.innerHTML = "Bravo ! Le contenu vient de changer.";
}
-
document.querySelector("#monPara")retrouve dans le DOM la balise d’id monPara; -
.innerHTML = "..."remplace son contenu. Au clic, le texte du paragraphe change — sans recharger la page.
Définition 12 — Sélectionner et modifier dans le DOM
Sélectionner un élément :
-
document.getElementById("monPara"): par sonid; -
document.querySelector("#monPara"): par un sélecteur CSS (le premier qui correspond) ; -
document.querySelectorAll(".bouton"): tous ceux qui correspondent.
Puis le modifier :
-
.textContentou.innerHTML: changer le contenu ; -
.style.color,.style.background… : changer la forme ; -
.classList.add("actif")/.classList.remove("actif"): ajouter/retirer une classe CSS ; -
.value: lire (ou écrire) le contenu d’un champ de formulaire.
Exemple — Réagir à une saisie
Une zone de texte, un bouton, et un paragraphe qui salue l’utilisateur :
<input type="text" id="nom">
<button onclick="saluer()">Bonjour</button>
<p id="message"></p>
function saluer() {
    let nom = document.querySelector("#nom").value;   // lire le champ
    document.querySelector("#message").textContent = "Bonjour " + nom + " !";
}
Rien n’est envoyé au serveur : tout se passe dans le navigateur, instantanément.
À retenir — Côté client, côté serveur
Le JavaScript est le langage de l’interaction côté client : il s’exécute sur votre machine, après réception de la page, pour les réactions immédiates (afficher/masquer, vérifier qu’un champ n’est pas vide…). D’autres traitements se font côté serveur, sur la machine distante, dans un autre langage — par exemple PHP, ou Python : consulter une base de données, vérifier un mot de passe, générer une page personnalisée. Savoir qui fait quoi est essentiel : ce qui se passe côté client est visible et modifiable par l’utilisateur, donc jamais sûr pour des vérifications sensibles.
Remarque — Faut-il apprendre PHP ? (mise au point)
Pour l’interaction dans la page, le programme s’en tient au JavaScript — il n’y a pas d’autre langage à connaître de ce côté. PHP n’est cité ici que comme exemple de langage côté serveur, pour bien opposer « ce que fait le client » et « ce que fait le serveur ». Le programme précise d’ailleurs qu’il ne s’agit pas de développer une expertise dans ces langages (PHP comme JavaScript) : on doit savoir distinguer les rôles, pas coder un serveur en PHP. C’est en Terminale, avec les bases de données, que le « côté serveur » sera approfondi.
Assembler les trois langages : une page complète#
Voici une page autonome qui réunit tout : la structure (HTML), la mise en forme avec Flexbox (CSS) et l’interactivité (JavaScript). L’utilisateur tape un article, clique sur Ajouter, et l’article s’ajoute à une liste — sans jamais recharger la page.
<!doctype html>
<html lang="fr">
<head>
  <meta charset="utf-8">
  <title>Ma liste</title>
  <style>
    body      { font-family: sans-serif; margin: 20px; }
    .ligne    { display: flex; gap: 8px; }      /* champ + bouton en ligne */
    #liste li { color: darkblue; }
  </style>
</head>
<body>
  <h1>Ma liste de courses</h1>
  <div class="ligne">
    <input type="text" id="article" placeholder="Un article...">
    <button onclick="ajouter()">Ajouter</button>
  </div>
  <ul id="liste"></ul>

  <script>
    function ajouter() {
        let champ = document.querySelector("#article");
        let texte = champ.value;                // lire la saisie
        if (texte !== "") {                     // ignorer une saisie vide
            let liste = document.querySelector("#liste");
            liste.innerHTML += "<li>" + texte + "</li>";   // ajouter un <li>
            champ.value = "";                   // vider le champ
        }
    }
  </script>
</body>
</html>
-
le
<style>met en forme et aligne le champ et le bouton avec Flexbox ; -
au clic,
ajouter()lit le champ (.value), teste qu’il n’est pas vide, ajoute un<li>à la liste, puis vide le champ ; -
les trois langages coopèrent, et tout se déroule côté client.
▶ Exercices d'application : exercices 17 à 21 (JavaScript ; client ou serveur)
Les formulaires : envoyer des données#
Jusqu’ici le client recevait. Un formulaire lui permet d’envoyer des données au serveur (identifiants, recherche, message…).
<form action="/connexion" method="post">
    <label for="pseudo">Pseudo :</label>
    <input type="text" name="pseudo" id="pseudo">
    <input type="password" name="mdp">
    <button type="submit">Se connecter</button>
</form>
-
action: l’adresse sur le serveur qui recevra les données ; -
method: comment les envoyer —get(données dans l’URL) oupost(données dans le corps de la requête) ; -
chaque
<input>a unname: c’est l’étiquette sous laquelle sa valeur arrive au serveur.
Remarque — Quelques types de champs
L’attribut type d’un <input> choisit la nature du champ : text (texte visible), password (masqué), radio (un seul choix parmi plusieurs), checkbox (cases à cocher, plusieurs choix possibles), email, number, date… Un <input type="submit"> (ou un <button type="submit">) envoie le formulaire vers l’action.
Règle 7 — GET ou POST pour un formulaire ?
-
GET: les données apparaissent dans l’URL après un?, sous la formeclef=valeurséparées par&(.../recherche?q=chat&tri=date). Pratique pour une recherche qu’on peut partager ou mettre en favori ; à éviter pour un mot de passe (visible et enregistré dans l’historique). -
POST: les données ne sont pas dans l’URL. À utiliser dès qu’on envoie quelque chose de sensible ou qui modifie l’état du serveur (connexion, publication…).
Pour les curieux (facultatif) — Le web dynamique
Quand le serveur fabrique la page en fonction de la requête (heure, utilisateur connecté, résultats d’une recherche), on parle de web dynamique. Un programme s’exécute alors côté serveur, dans un langage comme PHP, Python (Flask), etc., pour générer le HTML renvoyé. C’est ce qui distingue un site vivant d’un simple fichier figé.
▶ Exercices d'application : exercices 22, 23 et 28 (lire et écrire un formulaire)
Les cookies : ce que le navigateur retient#
Le protocole HTTP est sans mémoire : chaque requête est traitée seule, et le serveur ne sait pas, a priori, que deux requêtes viennent du même visiteur. Pour s’en souvenir (rester connecté, garder un panier, retenir une langue), le serveur demande au navigateur de garder une petite information : un cookie.
Règle 8 — Le cookie : mémorisé dans le client, retransmis au serveur
-
Le serveur envoie le cookie dans un en-tête de sa réponse,
Set-Cookie, sous la formenom=valeur. -
Le navigateur (le client) le mémorise, rangé avec le nom du site qui l’a déposé.
-
À chaque nouvelle requête vers ce même site, le navigateur le retransmet automatiquement dans l’en-tête
Cookie. Il ne l’envoie jamais à un autre site.
HTTP/1.1 200 OK                          <- reponse du serveur
Set-Cookie: langue=fr; Max-Age=2592000

GET /accueil.html HTTP/1.1               <- requete suivante du navigateur
Cookie: langue=fr
La durée est fixée par le serveur : Max-Age=2592000 (en secondes) garde le cookie 30 jours ; sans durée, il est effacé à la fermeture du navigateur.
Remarque — Usages et vie privée
Les cookies servent à rester connecté (le cookie contient un identifiant de session), à garder un panier ou des préférences. Mais des cookies déposés par des régies publicitaires présentes sur de nombreux sites permettent aussi de suivre un internaute d’un site à l’autre. Les sites doivent donc demander l’accord de l’utilisateur pour les cookies qui ne sont pas indispensables : c’est le rôle des bandeaux « Accepter / Refuser ». On peut consulter et effacer ses cookies dans le navigateur (F12, onglet Application ou Stockage). Enfin, un cookie est stocké chez le client : l’utilisateur peut le lire et le modifier, donc le serveur ne doit jamais lui faire une confiance aveugle.
▶ Exercices d'application : exercice 24 (cookies)
Un peu d’histoire#
Pour les curieux (facultatif) — D’ARPANET au CERN
Fin des années 1960, la recherche militaire américaine crée ARPANET, l’ancêtre d’Internet. Dans les années 1970, Vinton Cerf et Robert Kahn conçoivent TCP/IP, la famille de protocoles qui permet à des réseaux différents de communiquer : Internet devient possible. En 1983 apparaît le DNS, l’annuaire des noms.
1989–1991, au CERN (le laboratoire européen de physique, près de Genève), Tim Berners-Lee invente le World Wide Web pour que les chercheurs partagent leurs documents : il crée d’un coup le HTML, les URL et le protocole HTTP. Le premier site est en ligne en 1991. En 1993, le navigateur Mosaic popularise le Web auprès du grand public, et en 1995 Brendan Eich écrit JavaScript en dix jours. Trente ans plus tard, ce système imaginé pour quelques physiciens relie la planète entière.
Pour les curieux (facultatif) — Liens avec d’autres chapitres
-
Ce qu’il réutilise. Les adresses IP (quatre octets) et
utf-8viennent du chapitre Le binaire et l’écriture des nombres ; le DNS agit comme un dictionnaire (Les types construits) ; les serveurs sont des machines comme celles d’Architecture des ordinateurs et systèmes d’exploitation. -
En Terminale. Réseaux détaillera comment les routeurs choisissent le chemin des paquets ; le DOM deviendra un arbre (Les arbres) et le
httpss’expliquera en Cryptographie.
Bilan — la carte mémoire#
| Notion | À retenir |
|---|---|
| Internet vs Web | Internet \(=\) le réseau ; le Web \(=\) un service (pages \(+\) liens) dessus |
| Protocole | ensemble de règles pour communiquer (ex. HTTP, TCP/IP) |
| Adresse IP | « numéro » unique d’une machine (ex. 193.51.208.14) |
| Paquets | message découpé, routé indépendamment, réassemblé à l’arrivée |
| Routeur | aiguille les paquets vers la destination ; le DNS traduit nom \(\to\) IP |
| Client / serveur | le client demande, le serveur fournit ; P2P \(=\) chacun les deux |
| Fiabilité (bit alterné) | accusé de réception \(+\) renvoi si perte ; un bit 0/1 évite les doublons |
| URL | protocole://domaine/chemin ; https \(=\) sécurisé (chiffré) |
| HTTP | requête (GET/POST) \(\to\) réponse (code 200, 304, 404…) |
| Une page | souvent des dizaines de requêtes (HTML, CSS, JS, images…) |
| Outils dev | F12, onglet Réseau : voir les requêtes, méthodes, codes, tailles |
| HTML | fond : structure en balises ; id (unique) / class (partagée) ; arbre (DOM) |
| CSS | forme : sélecteurs balise / #id / .classe \(+\) { propriété: valeur; } |
| Flexbox | display:flex sur le conteneur : aligne les enfants en ligne (gap, justify-content) |
| JavaScript | comportement : événement (click…) \(\to\) querySelector \(+\) .value/DOM, côté client |
| Formulaire | <form action method> ; POST pour envoyer/du sensible |
| Cookie | Set-Cookie : mémorisé par le client, renvoyé au serveur à chaque requête vers ce site |
Retour à la situation de départ
-
Le navigateur (le client) obtient du DNS l’adresse IP du serveur, puis lui envoie une requête HTTP
GET, découpée en paquets aiguillés par des routeurs (§ II à IV). Le serveur répond (code200) avec le HTML, et le navigateur demande ensuite les feuilles CSS, les scripts et les images avant d’afficher la page (§ IV). -
Le récepteur renvoie un accusé de réception ; sans accusé au bout d’un délai, l’émetteur renvoie le paquet, et un bit alterné
0/1permet au récepteur de reconnaître un doublon (§ II). -
Par un cookie : le serveur demande au navigateur de mémoriser une petite information (
Set-Cookie), que le navigateur lui renvoie à chaque requête vers ce site (§ VIII).
Erreurs fréquentes#
-
Confondre Internet et le Web : l’un est le réseau, l’autre un service qui roule dessus.
-
Croire que HTML est un langage de programmation : c’est un langage de balisage (structure).
-
Oublier de fermer une balise (
</p>) ou les emboîter en les croisant. -
Mélanger les rôles HTML / CSS / JS (fond / forme / comportement).
-
Confondre
idetclass: unidest unique dans la page, uneclassest partagée ; en CSS,#pour l’id,.pour la classe. -
Envoyer un mot de passe en
GET: il finit visible dans l’URL et l’historique. -
Croire qu’une vérification côté client (JS) est sûre : l’utilisateur peut la contourner ; le serveur doit re-vérifier.
-
Croire qu’afficher une page ne demande qu’une seule requête : il en faut souvent des dizaines (CSS, JS, images, polices…).
-
Mettre
display:flexsur un enfant au lieu du conteneur : c’est le conteneur qui devient flexible, ses enfants s’alignent.
Savoir-faire à maîtriser#
À la fin du chapitre, je sais…
-
expliquer la différence entre Internet et le Web, et ce qu’est un protocole ;
-
dire à quoi servent une adresse IP, un paquet, un routeur, le DNS ;
-
dérouler le protocole du bit alterné (accusé de réception, renvoi, doublon) sur un scénario de perte ;
-
décomposer une URL et reconnaître une page sécurisée ;
-
distinguer ce qui relève du client et du serveur, et
GETdePOST; -
observer les requêtes HTTP échangées avec les outils de développement (
F12, onglet Réseau) ; -
écrire et analyser une page HTML simple (balises,
id/class) et sa mise en forme CSS (sélecteursbalise,#id,.classe) ; -
disposer des éléments côte à côte avec Flexbox (
display:flex) ; -
rendre une page interactive : réagir à un événement, sélectionner un élément (
querySelector), lire un champ (.value) et modifier le DOM ; -
assembler HTML \(+\) CSS \(+\) JavaScript en une petite page interactive complète ;
-
écrire un formulaire et choisir sa méthode d’envoi ;
-
distinguer ce qu’un cookie fait mémoriser par le client et ce qui est retransmis au serveur.