Exercices#
Problèmes de synthèse et exercices type bac
Mode d’emploi
-
Chaque problème croise des notions de plusieurs chapitres, comme les exercices du bac, qui ne disent jamais « ceci est un exercice sur les piles ».
-
Sous chaque titre, la ligne Chapitres croisés indique ce qu’il faut avoir vu. Un problème peut être repris plus tard dans l’année, pour réviser.
-
Niveau : ★ échauffement, ★★ classique (niveau bac), ★★★ défi ; les coups de pouce et les corrigés se déplient sous chaque exercice.
-
▶ À programmer et tester en Python. Les classes
Pile,File,CelluleetNoeudsont celles du cours. -
Usage de l’IA, indiqué sur chaque exercice : aucune ; en appui (déboguer, reformuler, vérifier ; la réponse finale est écrite et comprise par vous) ; l’exercice s’appuie sur une réponse d’IA. Voir la charte d’usage de l’IA.
Après les chapitres 1 à 3 (récursivité, programmation objet, structures linéaires)#
★★ Exercice 1 — Dérécursiver avec une pile #
≈ 30 min Chapitres croisés : Récursivité ; Piles
On considère la fonction récursive suivante, où n est un entier positif ou nul.
def afficher_binaire(n):
    if n >= 2:
        afficher_binaire(n // 2)
    print(n % 2, end="")
-
Dérouler l’appel
afficher_binaire(13): donner la liste des appels successifs, puis ce qui est affiché. Que représente l’affichage obtenu ? -
Dessiner la pile d’appels au moment où l’appel le plus profond s’exécute (sommet en haut). Expliquer pourquoi le chiffre affiché en premier est celui du dernier appel lancé.
-
▶ Écrire une fonction non récursive
binaire(n)qui renvoie l’écriture binaire densous forme de chaîne (par exemplebinaire(13)renvoie"1101"etbinaire(0)renvoie"0"). Elle utilisera unePilepour jouer le rôle de la pile d’appels.Coup de pouce
Deux boucles : la première calcule les restes
n % 2et les range dans la pile ; la seconde les ressort pour construire la chaîne. Attention au casn = 0, qui doit produire un chiffre. -
On remplace la
Pilepar uneFile(enfileretdefilerà la place deempileretdepiler). Que renvoie alors l’appel pourn = 13? Expliquer.
Corrigé
Remarque
On donne une version de chaque fonction ; d’autres écritures correctes sont possibles. Le fichier complet, corrige_synthese_terminale.py, est en ligne : https://github.com/MathThibaud/nsi-fichiers-eleves/tree/main/corriges/terminale/synthese.
1. Appels successifs : afficher_binaire(13) \(\to\) (6) \(\to\) (3) \(\to\) (1). L’appel (1) ne relance rien (\(1 < 2\)) et affiche 1 ; puis, en remontant, (3) affiche 1, (6) affiche 0 et (13) affiche 1. Affichage : 1101, l’écriture binaire de \(13\) (\(8 + 4 + 1\)).
2. Au moment de l’appel le plus profond, la pile contient, du sommet vers le bas : afficher_binaire(1), (3), (6), (13). Chaque appel affiche son chiffre après le retour de l’appel qu’il a lancé : les affichages se font donc dans l’ordre où les appels quittent la pile, c’est-à-dire du dernier lancé au premier (LIFO). Or le dernier appel porte le chiffre de poids fort : on obtient les chiffres dans le bon ordre, alors que les divisions par \(2\) les calculent du poids faible au poids fort.
3.
def binaire(n):
    p = Pile()
    p.empiler(n % 2)
    n = n // 2
    while n > 0:
        p.empiler(n % 2)
        n = n // 2
    resultat = ""
    while not p.est_vide():
        resultat = resultat + str(p.depiler())
    return resultat
Le premier reste est empilé avant la boucle : ainsi binaire(0) renvoie bien "0". La pile remplace la pile d’appels : elle garde les chiffres « en attente » et les rend dans l’ordre inverse.
4. Avec une file, les chiffres ressortent dans l’ordre où ils ont été calculés (FIFO), du poids faible au poids fort : on obtient "1011", l’écriture binaire à l’envers. C’est précisément le caractère LIFO de la pile qui remet les chiffres dans l’ordre.
★★ Exercice 2 — Annuler et rétablir #
≈ 45 min Chapitres croisés : Programmation objet ; Piles
Un éditeur de texte très simple garde le texte saisi dans un attribut texte (une chaîne). Il propose deux boutons : Annuler, qui revient au texte d’avant la dernière modification, et Rétablir, qui refait une modification qu’on vient d’annuler. Pour cela, l’objet possède deux piles : annulations contient les textes précédents, retablissements les textes annulés.
class Editeur:
    def __init__(self):
        ...

    def ecrire(self, mot):
        """ajoute mot a la fin du texte"""
        ...

    def annuler(self):
        """revient au texte precedent (sans effet s'il n'y en a pas)"""
        ...

    def retablir(self):
        """refait la derniere modification annulee (sans effet sinon)"""
        ...
-
▶ Écrire la méthode
__init__: le texte est vide au départ et les deux piles aussi. -
On exécute les instructions ci-dessous. Donner, après chacune, la valeur de
e.texteet le contenu des deux piles (dessinées verticalement, sommet en haut).e = Editeur() e.ecrire("Bon") e.ecrire("jour") e.annuler() e.retablir() e.annuler() e.ecrire("soir") -
▶ Écrire les méthodes
ecrire,annuleretretablir, en accord avec le déroulé de la question 2.Coup de pouce
Avant de modifier le texte, on sauvegarde l’ancien dans la pile qui permettra d’y revenir. Annuler et rétablir sont symétriques : chacune sauvegarde le texte courant dans l’autre pile.
-
Après la dernière instruction de la question 2, un appel à
e.retablir()ne doit rien changer. Pourquoi ce choix est-il raisonnable, et quelle ligne de votre méthodeecrirele garantit-elle ?
Corrigé
1.
    def __init__(self):
        self.texte = ""
        self.annulations = Pile()
        self.retablissements = Pile()
2. Les piles sont dessinées verticalement, sommet en haut.
| Instruction | e.texte |
annulations |
retablissements |
||
|---|---|---|---|---|---|
Editeur() |
"" |
vide | vide | ||
ecrire("Bon") |
"Bon" |
|
vide | ||
ecrire("jour") |
"Bonjour" |
|
vide | ||
annuler() |
"Bon" |
|
|
||
retablir() |
"Bonjour" |
|
vide | ||
annuler() |
"Bon" |
|
|
||
ecrire("soir") |
"Bonsoir" |
|
vide |
3.
    def ecrire(self, mot):
        self.annulations.empiler(self.texte)
        self.texte = self.texte + mot
        self.retablissements = Pile()

    def annuler(self):
        if not self.annulations.est_vide():
            self.retablissements.empiler(self.texte)
            self.texte = self.annulations.depiler()

    def retablir(self):
        if not self.retablissements.est_vide():
            self.annulations.empiler(self.texte)
            self.texte = self.retablissements.depiler()
4. Après ecrire("soir"), le texte annulé ("Bonjour") appartient à une « histoire » abandonnée : le rétablir effacerait sans prévenir ce qu’on vient d’écrire. Tous les éditeurs se comportent ainsi. C’est la ligne self.retablissements = Pile() de ecrire qui vide la pile des rétablissements à chaque nouvelle saisie.
★★★ Exercice 3 — Listes chaînées récursives #
≈ 45 min Chapitres croisés : Programmation objet ; Listes chaînées ; Récursivité
On rappelle la classe Cellule du cours : une liste chaînée est soit None (liste vide), soit une cellule dont l’attribut suivante est elle-même une liste chaînée. C’est une définition récursive, qui appelle naturellement des fonctions récursives.
class Cellule:
    def __init__(self, v, s):
        self.valeur = v
        self.suivante = s

lst = Cellule(3, Cellule(1, Cellule(4, None)))
-
Représenter
lstpar un schéma de cellules reliées par des flèches. -
▶ Écrire les fonctions récursives
longueur(lst)etsomme(lst), qui renvoient le nombre d’éléments et leur somme (\(0\) pour une liste vide). -
▶ Écrire la fonction récursive
contient(lst, x), qui renvoieTruesixest dans la liste etFalsesinon. Pourquoi peut-elle s’arrêter avant la fin de la liste ? -
▶ On veut une fonction
renverser(lst)qui renvoie une nouvelle liste chaînée contenant les mêmes valeurs dans l’ordre inverse, sans modifierlst. Écrire une fonction récursiverenverser_dans(lst, acc), oùaccest la liste déjà renversée, puis en déduirerenverser.Coup de pouce
Penser à une pile d’assiettes : on prend la première cellule de
lstet on la pose en tête deacc(une nouvelle cellule), puis on continue avec le reste. Que vautaccau tout premier appel ? -
Ajouter une cellule en tête coûte une seule opération. Combien d’opérations faut-il pour ajouter une cellule en queue d’une liste de \(n\) cellules ? Comparer avec les opérations d’une pile.
Corrigé
1. 3 | \(\bullet\)\(\to\)1 | \(\bullet\)\(\to\)4 | \(\bullet\)\(\to\)None
2. On suit la définition récursive : liste vide, ou une cellule suivie d’une liste.
def longueur(lst):
    if lst is None:
        return 0
    return 1 + longueur(lst.suivante)

def somme(lst):
    if lst is None:
        return 0
    return lst.valeur + somme(lst.suivante)
3.
def contient(lst, x):
    if lst is None:
        return False
    if lst.valeur == x:
        return True
    return contient(lst.suivante, x)
Dès que x est trouvé, la fonction renvoie True sans faire d’appel récursif : inutile de regarder la suite.
4.
def renverser_dans(lst, acc):
    if lst is None:
        return acc
    return renverser_dans(lst.suivante, Cellule(lst.valeur, acc))

def renverser(lst):
    return renverser_dans(lst, None)
Pour lst \(= 3 \to 1 \to 4\) : acc vaut successivement None, puis \(3\), puis \(1 \to 3\), puis \(4 \to 1 \to 3\). On crée de nouvelles cellules : lst n’est pas modifiée.
Autre méthode : la même idée avec une boucle : on parcourt lst et on pose chaque valeur en tête du résultat, qui joue le rôle de acc.
def renverser_iteratif(lst):
    resultat = None
    while lst is not None:
        resultat = Cellule(lst.valeur, resultat)
        lst = lst.suivante
    return resultat
5. Pour ajouter en queue, il faut d’abord atteindre la dernière cellule en suivant les \(n\) liens : environ \(n\) opérations (coût linéaire), contre une seule en tête. C’est pourquoi une liste chaînée fait une excellente pile (on empile et dépile en tête, en une opération), mais une file médiocre si l’on ne garde pas aussi un accès direct à la dernière cellule.
Après le chapitre 5 (arbres)#
★★★ Exercice 4 — Trier avec un arbre binaire de recherche #
≈ 45 min Chapitres croisés : Arbres ; Récursivité ; coût des algorithmes
On dispose de la fonction inserer du cours, qui insère x dans l’ABR a et renvoie l’arbre obtenu (une valeur égale à celle d’un nœud va à droite).
def inserer(a, x):
    """Insere x dans l'ABR a et renvoie l'arbre obtenu."""
    if a is None:
        return Noeud(x)
    if x < a.valeur:
        a.gauche = inserer(a.gauche, x)
    else:
        a.droite = inserer(a.droite, x)
    return a
-
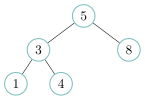
Dessiner l’ABR obtenu en insérant successivement \(5, 3, 8, 1, 4\) dans un arbre vide.
-
▶ Écrire une fonction récursive
infixe_dans(a, resultat)qui ajoute à la fin de la liste Pythonresultatles valeurs deadans l’ordre du parcours infixe. Que contientresultatpour l’arbre de la question 1 ? -
▶ En déduire une fonction
tri_abr(tab)qui renvoie une liste contenant les valeurs detabtriées dans l’ordre croissant. -
Que renvoie
tri_abr([3, 1, 3])? Où le second3est-il placé dans l’arbre ? Quelle modification deinsererdonnerait au contraire un tri sans doublon (chaque valeur une seule fois) ? -
On trie le tableau
[1, 2, 3, …, 100], déjà trié. Quelle est la hauteur de l’arbre construit ? Combien de comparaisons coûte l’insertion du dernier élément ? En déduire l’ordre de grandeur du coût du tri dans ce cas, et le comparer au cas d’un tableau mélangé, pour lequel la hauteur reste de l’ordre de \(\log_2(n)\) (dans un essai avec \(100\) valeurs mélangées, l’arbre avait une hauteur de \(12\)).Coup de pouce
Insérer une valeur parcourt un seul chemin de la racine vers le bas : son coût est au plus la hauteur. Ici, chaque nouvelle valeur est plus grande que toutes les autres : où va-t-elle ?
-
Avec un tableau trié de \(10\,000\) valeurs, Python déclenche une
RecursionError. Expliquer pourquoi, en lien avec la question précédente.
Corrigé
1. Racine \(5\) ; à gauche \(3\) (avec \(1\) à sa gauche et \(4\) à sa droite) ; à droite \(8\).
2.
def infixe_dans(a, resultat):
    if a is not None:
        infixe_dans(a.gauche, resultat)
        resultat.append(a.valeur)
        infixe_dans(a.droite, resultat)
Pour l’arbre de la question 1, resultat contient [1, 3, 4, 5, 8] : le parcours infixe d’un ABR donne les valeurs triées.
3.
def tri_abr(tab):
    a = None
    for x in tab:
        a = inserer(a, x)
    resultat = []
    infixe_dans(a, resultat)
    return resultat
4. tri_abr([3, 1, 3]) renvoie [1, 3, 3] : les doublons sont conservés. Le premier 3 est la racine, 1 va à sa gauche ; le second 3 n’est pas plus petit que la racine, il va donc à droite (convention du cours : égal à droite) et devient le fils droit de la racine. Le parcours infixe visite la racine, puis son sous-arbre droit : les deux 3 sortent côte à côte. Pour un tri sans doublon, il suffit de ne rien faire quand x == a.valeur : on remplace else: par elif x > a.valeur:, et tri_abr([3, 1, 3]) renvoie alors [1, 3]. C’est une autre convention, que l’on rencontre dans certains sujets (ABR « sans doublon ») : toujours lire celle de l’énoncé.
5. Chaque valeur est plus grande que toutes les précédentes : elle va toujours à droite. L’arbre est un « peigne » de hauteur \(100\), en réalité une liste chaînée. L’insertion du dernier élément compare \(100\) à \(99\) valeurs. Au total, \(0 + 1 + \dots + 99 = 4\,950\) comparaisons, soit environ \(n^2/2\) : coût quadratique, comme un tri par insertion. Pour un tableau mélangé, chaque insertion coûte au plus une douzaine de comparaisons ici, de l’ordre de \(\log_2(n)\) : environ \(n\log_2(n)\) au total, comme le tri fusion (chapitre Diviser pour régner).
6. inserer s’appelle récursivement une fois par niveau traversé : avec \(10\,000\) valeurs triées, l’arbre a une hauteur de \(10\,000\), donc il faut \(10\,000\) appels emboîtés. Cela dépasse la limite de la pile d’appels de Python (environ \(1\,000\) par défaut) : RecursionError. La forme de l’arbre a donc un coût en temps et en mémoire.
★★ Exercice 5 — La largeur d’un arbre #
≈ 30 min Chapitres croisés : Arbres ; Files ; dictionnaires
On appelle niveau d’un nœud le nombre de nœuds sur le chemin qui va de la racine jusqu’à lui (la racine est au niveau \(1\)). La largeur d’un arbre est le plus grand nombre de nœuds situés sur un même niveau.
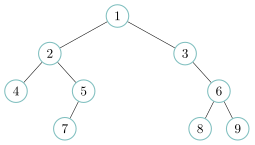
-
Pour l’arbre ci-dessus, donner le nombre de nœuds de chaque niveau, puis sa largeur.
-
▶ Écrire une fonction
noeuds_par_niveau(a)qui renvoie un dictionnaire associant à chaque niveau son nombre de nœuds (pour l’arbre ci-dessus :{1: 1, 2: 2, 3: 3, 4: 3}). Elle s’inspirera du parcours en largeur du cours, en enfilant des couples(noeud, niveau).Coup de pouce
Quand on défile un couple
(n, niveau), ses enfants sont au niveauniveau + 1. Le dictionnaire se remplit comme un compteur d’occurrences. -
▶ En déduire une fonction
largeur_max(a). -
On remplace la
Filepar unePile. Le dictionnaire obtenu est-il différent ? L’ordre dans lequel les nœuds sont visités l’est-il ? Justifier.
Corrigé
1. Niveau \(1\) : \(1\) nœud (\(1\)) ; niveau \(2\) : \(2\) (\(2\), \(3\)) ; niveau \(3\) : \(3\) (\(4\), \(5\), \(6\)) ; niveau \(4\) : \(3\) (\(7\), \(8\), \(9\)). Largeur : \(\mathbf{3}\).
2.
def noeuds_par_niveau(a):
    compte = {}
    if a is None:
        return compte
    f = File()
    f.enfiler((a, 1))
    while not f.est_vide():
        n, niveau = f.defiler()
        if niveau in compte:
            compte[niveau] = compte[niveau] + 1
        else:
            compte[niveau] = 1
        if n.gauche is not None:
            f.enfiler((n.gauche, niveau + 1))
        if n.droite is not None:
            f.enfiler((n.droite, niveau + 1))
    return compte
3.
def largeur_max(a):
    compte = noeuds_par_niveau(a)
    maxi = 0
    for niveau in compte:
        if compte[niveau] > maxi:
            maxi = compte[niveau]
    return maxi
Pour l’arbre vide, le dictionnaire est vide et la fonction renvoie \(0\).
4. Le dictionnaire est le même : chaque nœud est visité une fois, avec son niveau, quelle que soit la structure utilisée. Seul l’ordre de visite change : avec une file, on visite niveau par niveau (largeur) ; avec une pile, on s’enfonce d’abord dans une branche (profondeur). Ici, l’ordre ne compte pas, car on se contente de compter.
Après les chapitres 6 à 8 (bases de données, diviser pour régner, graphes)#
★★ Exercice 6 — Une médiathèque, de la table à l’objet #
≈ 45 min Chapitres croisés : Bases de données ; Programmation objet
Une médiathèque gère ses prêts avec trois relations : adherent(id_adherent, nom, prenom), livre(id_livre, titre, auteur) et emprunt(id_emprunt, #id_adherent, #id_livre, jour, rendu). L’attribut jour est le numéro, dans l’année, du jour de l’emprunt ; rendu vaut 1 si le livre a été rendu et 0 sinon.
id_adherent |
nom |
prenom |
|---|---|---|
| 1 | Durand | Lina |
| 2 | Rossi | Marco |
| 3 | Durand | Paul |
id_livre |
titre |
auteur |
|---|---|---|
| 10 | Le Petit Prince | Saint-Exupéry |
| 11 | Vingt mille lieues sous les mers | Verne |
| 12 | Les Misérables | Hugo |
| 13 | Le Tour du monde en 80 jours | Verne |
id_emprunt |
id_adherent |
id_livre |
jour |
rendu |
|---|---|---|---|---|
| 1 | 1 | 10 | 3 | 1 |
| 2 | 2 | 11 | 12 | 0 |
| 3 | 1 | 12 | 20 | 0 |
| 4 | 3 | 10 | 25 | 0 |
| 5 | 2 | 13 | 40 | 0 |
-
Pourquoi
id_livrene peut-il pas servir de clé primaire à la relationemprunt? Citer les clés étrangères de cette relation et la relation à laquelle chacune fait référence. -
Écrire une requête qui donne les titres des livres empruntés par Lina Durand. Pourquoi ne suffit-il pas de tester
nom = ’Durand’? -
Donner le résultat de la requête suivante :
SELECT COUNT(*) FROM emprunt WHERE rendu = 0; -
Écrire une requête qui donne, pour chaque auteur, le nombre d’emprunts de ses livres.
-
Marco Rossi rapporte Vingt mille lieues sous les mers. Écrire la requête qui met à jour la base.
-
Après cette mise à jour, un programme Python interroge la base et obtient la liste des emprunts non rendus, sous forme de triplets
(id_emprunt, titre, jour):lignes = [(3, "Les Misérables", 20), (4, "Le Petit Prince", 25), (5, "Le Tour du monde en 80 jours", 40)]▶ Écrire une classe
Empruntdont le constructeur reçoitnumero,titreetjour, avec une méthodeen_retard(self, aujourdhui)qui renvoieTruesi le prêt dure depuis plus de 21 jours le jour numéroaujourdhui. -
▶ Écrire une fonction
titres_en_retard(lignes, aujourdhui)qui construit la liste des objetsEmpruntpuis renvoie la liste des titres en retard. Que renvoie-t-elle pouraujourdhui = 47?Coup de pouce
Deux listes par compréhension : la première crée un objet par triplet (
for (numero, titre, jour) in lignes), la seconde ne garde que le titre des objets en retard.
Corrigé
1. Un même livre peut être emprunté plusieurs fois : le livre 10 apparaît dans les emprunts 1 et 4. Les valeurs de id_livre ne sont donc pas toutes distinctes, alors qu’une clé primaire doit identifier une seule ligne. Les clés étrangères sont id_adherent, qui fait référence à adherent(id_adherent), et id_livre, qui fait référence à livre(id_livre).
2.
SELECT livre.titre
FROM emprunt
JOIN adherent ON emprunt.id_adherent = adherent.id_adherent
JOIN livre ON emprunt.id_livre = livre.id_livre
WHERE adherent.nom = 'Durand' AND adherent.prenom = 'Lina';
Résultat : Le Petit Prince et Les Misérables. Deux adhérents s’appellent Durand : avec la seule condition nom = ’Durand’, on obtiendrait aussi le livre emprunté par Paul Durand (emprunt 4). On peut aussi écrire WHERE emprunt.id_adherent = 1.
3. La requête compte les emprunts non rendus : 4 (emprunts 2, 3, 4 et 5).
4.
SELECT livre.auteur, COUNT(*)
FROM emprunt
JOIN livre ON emprunt.id_livre = livre.id_livre
GROUP BY livre.auteur;
Résultat : Hugo \(1\), Saint-Exupéry \(2\), Verne \(2\).
5. On repère l’emprunt par sa clé primaire :
UPDATE emprunt
SET rendu = 1
WHERE id_emprunt = 2;
6.
class Emprunt:
    def __init__(self, numero, titre, jour):
        self.numero = numero
        self.titre = titre
        self.jour = jour

    def en_retard(self, aujourdhui):
        return aujourdhui - self.jour > 21
7.
def titres_en_retard(lignes, aujourdhui):
    emprunts = [Emprunt(numero, titre, jour) for (numero, titre, jour) in lignes]
    return [e.titre for e in emprunts if e.en_retard(aujourdhui)]
Le jour \(47\), les prêts durent depuis \(27\), \(22\) et \(7\) jours : la fonction renvoie ["Les Misérables", "Le Petit Prince"]. La base stocke les données, l’objet regroupe ces données et le comportement qui les concerne (la règle des 21 jours).
★★★ Exercice 7 — Ordonnancer des tâches qui dépendent les unes des autres #
≈ 60 min Chapitres croisés : Graphes ; Files ; Processus
Pour construire un logiciel, un système doit exécuter des tâches dont certaines ne peuvent commencer qu’une fois d’autres terminées. On représente ces dépendances par un dictionnaire qui associe à chaque tâche la liste de ses prérequis :
taches = {"A": [], "B": ["A"], "C": ["A"], "D": ["B", "C"],
          "E": ["C"], "F": ["D", "E"]}
-
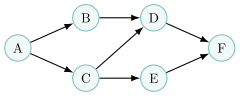
Dessiner le graphe orienté des dépendances : un arc va de
XversYquandXest un prérequis deY. -
▶ Écrire une fonction
successeurs(prerequis)qui renvoie le dictionnaire associant à chaque tâche la liste des tâches qui en dépendent (pourtaches:"A"est associée à["B", "C"],"F"à[]). -
Comme l’ordonnanceur d’un système d’exploitation, on range dans une file les tâches prêtes, c’est-à-dire celles dont tous les prérequis sont faits. Au départ, on enfile les tâches sans prérequis. Tant que la file n’est pas vide, on défile une tâche, on l’exécute, puis on retire \(1\) au nombre de prérequis restants de chacun de ses successeurs ; un successeur dont ce nombre tombe à \(0\) est enfilé. Dérouler cet algorithme sur
tachesen donnant le contenu de la file après chaque tâche exécutée, puis l’ordre d’exécution. -
▶ Écrire une fonction
ordre_execution(prerequis)qui renvoie la liste des tâches dans l’ordre d’exécution, ouNonesi certaines tâches ne peuvent jamais être exécutées. On utilisera la classeFiledu cours et un dictionnaireattente(tâche \(\to\) nombre de prérequis non encore faits).Coup de pouce
À la fin, comparer la longueur de la liste obtenue au nombre de tâches.
-
On ajoute une dépendance :
Adoit maintenant attendreF.taches["A"] = ["F"]Que renvoie
ordre_execution(taches)? Que contient le graphe ? Quelle situation du chapitre Processus reconnaît-on ? -
Combien de fois, au plus, chaque tâche est-elle enfilée ? chaque dépendance examinée ? En déduire le coût de l’algorithme en fonction du nombre de tâches et de dépendances.
Corrigé
1. Les arcs sont A\(\to\)B, A\(\to\)C, B\(\to\)D, C\(\to\)D, C\(\to\)E, D\(\to\)F et E\(\to\)F.
2.
def successeurs(prerequis):
    succ = {}
    for t in prerequis:
        succ[t] = []
    for t in prerequis:
        for p in prerequis[t]:
            succ[p].append(t)
    return succ
3. Au départ, les nombres de prérequis restants sont A \(0\), B \(1\), C \(1\), D \(2\), E \(1\), F \(2\), et la file contient A.
| Tâche exécutée | Effet sur les successeurs | File (tête à gauche) |
|---|---|---|
A |
B et C passent à \(0\) : enfilées |
B C |
B |
D passe à \(1\) |
C |
C |
D et E passent à \(0\) : enfilées |
D E |
D |
F passe à \(1\) |
E |
E |
F passe à \(0\) : enfilée |
F |
F |
aucun successeur | vide |
Ordre d’exécution : A, B, C, D, E, F.
4.
def ordre_execution(prerequis):
    succ = successeurs(prerequis)
    attente = {}
    for t in prerequis:
        attente[t] = len(prerequis[t])
    f = File()
    for t in prerequis:
        if attente[t] == 0:
            f.enfiler(t)
    ordre = []
    while not f.est_vide():
        t = f.defiler()
        ordre.append(t)
        for s in succ[t]:
            attente[s] = attente[s] - 1
            if attente[s] == 0:
                f.enfiler(s)
    if len(ordre) < len(prerequis):
        return None
    return ordre
5. La fonction renvoie None : plus aucune tâche n’est sans prérequis, la file est vide dès le départ et aucune tâche n’est exécutée. Le graphe contient désormais des cycles, par exemple A\(\to\)B\(\to\)D\(\to\)F\(\to\)A. C’est un interblocage : comme des processus qui attendent chacun une ressource détenue par un autre, chaque tâche du cycle attend la fin d’une autre tâche du cycle. Le contrôle len(ordre) < len(prerequis) le détecte : si un cycle existe, ses tâches ne sont jamais enfilées.
6. Une tâche est enfilée au plus une fois (au moment où son nombre de prérequis restants tombe à \(0\), ce qui n’arrive qu’une fois). Chaque dépendance est examinée une fois dans successeurs, puis une fois quand son prérequis est exécuté. Le coût est donc linéaire en (nombre de tâches \(+\) nombre de dépendances).
Après les chapitres 9 et 10 (réseaux, cryptographie)#
★★ Exercice 8 — Router des paquets avec un dictionnaire #
≈ 60 min Chapitres croisés : Réseaux ; Graphes ; Files
Un réseau de cinq routeurs est représenté par un dictionnaire : à chaque routeur est associé le dictionnaire de ses voisins, avec le débit de la liaison en Mbit/s.
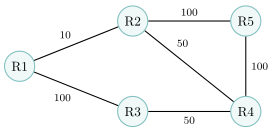
reseau = {"R1": {"R2": 10, "R3": 100},
          "R2": {"R1": 10, "R4": 50, "R5": 100},
          "R3": {"R1": 100, "R4": 50},
          "R4": {"R2": 50, "R3": 50, "R5": 100},
          "R5": {"R2": 100, "R4": 100}}
-
En OSPF, le coût d’une liaison vaut \(10^8/\text{débit}\), le débit étant en bit/s. ▶ Écrire une fonction
cout(debit)qui prend un débit en Mbit/s et renvoie ce coût. Donner les coûts des liaisons à \(10\), \(50\) et \(100\) Mbit/s. -
Le protocole RIP compte les sauts. ▶ Écrire une fonction
sauts(reseau, depart)qui renvoie le dictionnaire associant à chaque routeur son nombre de sauts depuisdepart, par un parcours en largeur avec uneFile. Quelle route RIP suit un paquet de R1 vers R5 ?Coup de pouce
C’est le calcul des distances du parcours en largeur du chapitre Graphes : un voisin découvert depuis
rest à la distance derplus \(1\). -
▶ Écrire une fonction
est_chemin(reseau, chemin), oùcheminest une liste de routeurs, qui vérifie que deux routeurs consécutifs sont toujours reliés, puis une fonctioncout_chemin(reseau, chemin)qui renvoie la somme des coûts OSPF de ses liaisons. -
▶ Écrire une fonction
meilleur_chemin(reseau, chemins)qui renvoie, parmi une liste de chemins candidats, un chemin valide de coût minimal. L’appliquer aux candidatsR1-R2-R5,R1-R3-R4-R5,R1-R2-R4-R5,R1-R3-R4-R2-R5etR1-R4-R5. Quelle route OSPF suit le paquet ? Comparer avec RIP et expliquer. -
La liaison R3–R4 tombe en panne. Écrire les deux instructions qui la retirent du dictionnaire, puis donner les nouvelles routes RIP et OSPF de R1 vers R5.
Corrigé
1.
def cout(debit):
    return 10**8 / (debit * 10**6)
\(10\) Mbit/s : coût \(10\) ; \(50\) Mbit/s : coût \(2\) ; \(100\) Mbit/s : coût \(1\).
2. C’est le parcours en largeur du chapitre Graphes, qui calcule les distances en nombre d’arêtes.
def sauts(reseau, depart):
    distance = {depart: 0}
    f = File()
    f.enfiler(depart)
    while not f.est_vide():
        r = f.defiler()
        for voisin in reseau[r]:
            if voisin not in distance:
                distance[voisin] = distance[r] + 1
                f.enfiler(voisin)
    return distance
Depuis R1 : R2 et R3 à \(1\) saut, R4 et R5 à \(2\) sauts. La route RIP de R1 vers R5 est R1–R2–R5 (\(2\) sauts, la seule de cette longueur).
3.
def est_chemin(reseau, chemin):
    for i in range(len(chemin) - 1):
        if chemin[i + 1] not in reseau[chemin[i]]:
            return False
    return True

def cout_chemin(reseau, chemin):
    total = 0
    for i in range(len(chemin) - 1):
        total = total + cout(reseau[chemin[i]][chemin[i + 1]])
    return total
4.
def meilleur_chemin(reseau, chemins):
    meilleur = None
    for c in chemins:
        if est_chemin(reseau, c):
            if meilleur is None or cout_chemin(reseau, c) < cout_chemin(reseau, meilleur):
                meilleur = c
    return meilleur
Coûts : R1–R2–R5 : \(10 + 1 = 11\) ; R1–R3–R4–R5 : \(1 + 2 + 1 = 4\) ; R1–R2–R4–R5 : \(10 + 2 + 1 = 13\) ; R1–R3–R4–R2–R5 : \(1 + 2 + 2 + 1 = 6\) ; R1–R4–R5 n’est pas un chemin (R1 et R4 ne sont pas reliés). OSPF choisit R1–R3–R4–R5 (coût \(4\)). RIP choisit R1–R2–R5, plus court en sauts, mais qui emprunte la liaison lente R1–R2 (\(10\) Mbit/s) : RIP ignore les débits, OSPF en tient compte.
5. La liaison figure dans les dictionnaires des deux routeurs :
del reseau["R3"]["R4"]
del reseau["R4"]["R3"]
La route RIP ne change pas (R1–R2–R5, \(2\) sauts). Pour OSPF, les candidats qui passent par R3–R4 ne sont plus des chemins ; il reste R1–R2–R5 (coût \(11\)) et R1–R2–R4–R5 (coût \(13\)) : le paquet passe désormais par R1–R2–R5, comme avec RIP.
★★ Exercice 9 — RSA miniature et exponentiation rapide #
≈ 45 min Chapitres croisés : Cryptographie ; Diviser pour régner ; Récursivité
Alice choisit \(p = 11\) et \(q = 17\) ; sa clé publique est \((e, n)\) avec \(e = 7\), et sa clé privée est \(d = 23\). Un nombre \(m\) (avec \(0 \leq m < n\)) se chiffre en \(c = m^e \bmod n\) et se déchiffre en \(m = c^d \bmod n\) (en Python, naïvement : c = m ** e % n, qui forme d’abord le nombre \(m^e\), géant dans un vrai RSA ; la question 4 fait mieux, comme pow(m, e, n) vu au chapitre Cryptographie).
-
Calculer \(n\) et \(\varphi = (p-1)(q-1)\), puis vérifier que \(e \times d \bmod \varphi = 1\).
-
Chiffrer à la main le nombre \(m = 42\), en calculant successivement \(42^2\), \(42^3\), \(42^6\) et \(42^7\) modulo \(n\) (on réduit modulo \(n\) après chaque multiplication).
-
Combien de multiplications faut-il pour calculer \(a^k\) en multipliant \(a\) par lui-même, une fois après l’autre ? Dans un vrai RSA, \(d\) a environ \(600\) chiffres : est-ce envisageable ?
-
On utilise plutôt la méthode diviser pour régner : \(a^k = \left(a^{k/2}\right)^2\) si \(k\) est pair, et \(a^k = \left(a^{(k-1)/2}\right)^2 \times a\) si \(k\) est impair. ▶ Écrire une fonction récursive
expo_mod(a, k, n)qui renvoie \(a^k \bmod n\) avec un seul appel récursif, en réduisant modulo \(n\) après chaque multiplication.Coup de pouce
Condition d’arrêt : \(a^0 = 1\). Ranger le résultat de l’appel sur
k // 2dans une variable avant de l’élever au carré. -
Compter les multiplications effectuées par
expo_mod(c, 23, 187)(élever au carré compte pour une). Quel est l’ordre de grandeur de ce nombre pour un exposant \(k\) quelconque ? -
▶ Déchiffrer le résultat de la question 2 avec
expo_mod. Chiffrer le message[72, 105].
Corrigé
1. \(n = 11 \times 17 = 187\) et \(\varphi = 10 \times 16 = 160\). \(e \times d = 7 \times 23 = 161 = 160 + 1\), donc \(e \times d \bmod \varphi = 1\).
2. \(42^2 = 1\,764 = 9 \times 187 + 81\), donc \(42^2 \bmod 187 = 81\). Puis \(81 \times 42 = 3\,402 = 18 \times 187 + 36\) : \(42^3 \bmod 187 = 36\). Puis \(36^2 = 1\,296 = 6 \times 187 + 174\) : \(42^6 \bmod 187 = 174\). Enfin \(174 \times 42 = 7\,308 = 39 \times 187 + 15\) : le chiffré est \(c = \mathbf{15}\).
3. Il faut \(k - 1\) multiplications (\(a \times a \times \dots \times a\)). Avec un exposant d’environ \(600\) chiffres, même à un milliard de multiplications par seconde, le calcul durerait des milliards de fois l’âge de l’Univers : c’est impossible.
4.
def expo_mod(a, k, n):
    if k == 0:
        return 1
    moitie = expo_mod(a, k // 2, n)
    carre = (moitie * moitie) % n
    if k % 2 == 0:
        return carre
    return (carre * a) % n
Un seul appel récursif, sur k // 2 : diviser l’exposant par deux, régner par l’appel récursif, combiner en élevant au carré (et en multipliant par \(a\) si \(k\) est impair). Le variant k est un entier positif qui diminue strictement, jusqu’à la condition d’arrêt \(k = 0\).
5. Les appels portent sur \(k = 23\), \(11\), \(5\), \(2\), \(1\), puis \(0\). Chaque appel avec \(k\) impair fait \(2\) multiplications (un carré et un produit par \(a\)), avec \(k\) pair une seule : \(2 + 2 + 2 + 1 + 2 = \mathbf{9}\) multiplications, contre \(22\) pour la méthode naïve. Le nombre d’appels est de l’ordre de \(\log_2 k\), donc il faut au plus environ \(2\log_2 k\) multiplications : pour un exposant de \(2\,048\) bits, quelques milliers de multiplications suffisent.
6. expo_mod(15, 23, 187) renvoie 42 : on retrouve bien le message. Le message [72, 105] se chiffre en [expo_mod(m, 7, 187) for m in [72, 105]], soit [30, 96].
Après les chapitres 11 à 14 (programmation dynamique, recherche textuelle, calculabilité, systèmes sur puce)#
★★★ Exercice 10 — Détecter un plagiat : la plus longue sous-chaîne commune #
≈ 45 min Chapitres croisés : Recherche textuelle ; Programmation dynamique
Pour repérer un passage recopié, on cherche la plus longue sous-chaîne commune à deux textes. Attention : une sous-chaîne est faite de caractères consécutifs (a[i:j]), contrairement à la sous-séquence du chapitre Programmation dynamique.
-
Donner la plus longue sous-chaîne commune à
"ALGORITHME"et"LOGARITHME". -
On dispose de la fonction
recherche_naive(motif, texte)du cours, qui renvoie la liste des positions demotifdanstexte. ▶ Écrire une fonctionplus_longue_naive(a, b)qui teste toutes les sous-chaînesa[i:j]deaet renvoie la plus longue qui apparaît dansb. Pour deux textes de \(n\) caractères, combien de sous-chaînes teste-t-elle environ ? Que penser de son coût ? -
On note \(L[i][j]\) la longueur de la plus longue sous-chaîne commune qui se termine par le caractère
a[i-1]dansaet parb[j-1]dansb(avec \(L[0][j] = L[i][0] = 0\)). Justifier que \(L[i][j] = L[i-1][j-1] + 1\) sia[i-1] == b[j-1], et \(L[i][j] = 0\) sinon. -
Remplir la table \(L\) pour
a = "ABAB"etb = "BABA". Où lit-on la longueur cherchée ? Donner une plus longue sous-chaîne commune.Coup de pouce
Contrairement à la sous-séquence, la réponse n’est pas dans le coin en bas à droite : c’est le maximum de toute la table.
-
▶ Écrire une fonction
plus_longue_dyn(a, b)qui remplit la table de bas en haut et renvoie une plus longue sous-chaîne commune (et non seulement sa longueur). Quel est son coût pour deux textes de \(n\) et \(m\) caractères ?
Corrigé
1. "RITHME" (\(6\) caractères), à la fin des deux mots.
2.
def plus_longue_naive(a, b):
    meilleure = ""
    for i in range(len(a)):
        for j in range(i + 1, len(a) + 1):
            if j - i > len(meilleure) and recherche_naive(a[i:j], b) != []:
                meilleure = a[i:j]
    return meilleure
Pour un texte a de \(n\) caractères, il y a \(n + (n - 1) + \dots + 1 = \dfrac{n(n+1)}{2}\) couples \((i, j)\), soit environ \(n^2/2\) sous-chaînes. Chacune peut déclencher une recherche naïve, qui examine jusqu’à \(n\) positions de départ (et compare jusqu’à \(j - i\) caractères à chacune) : le coût total est au moins de l’ordre de \(n^3\). Inutilisable sur deux textes de quelques milliers de caractères.
3. Si a[i-1] == b[j-1], une sous-chaîne commune qui se termine par ces deux caractères est une sous-chaîne commune qui se termine par a[i-2] et b[j-2] (éventuellement vide), prolongée par ce caractère : la plus longue mesure donc \(L[i-1][j-1] + 1\). Si les deux caractères sont différents, aucune sous-chaîne commune ne peut se terminer à la fois par l’un et par l’autre : \(L[i][j] = 0\).
4. Lignes : a = "ABAB" ; colonnes : b = "BABA".
B |
A |
B |
A |
||
|---|---|---|---|---|---|
| 0 | 0 | 0 | 0 | 0 | |
A |
0 | 0 | 1 | 0 | 1 |
B |
0 | 1 | 0 | 2 | 0 |
A |
0 | 0 | 2 | 0 | 3 |
B |
0 | 1 | 0 | 3 | 0 |
La longueur cherchée est le maximum de la table, \(3\). La case \(L[3][4] = 3\) correspond à la sous-chaîne qui se termine par a[2] : a[0:3] = "ABA" ; la case \(L[4][3]\) donne "BAB".
5. On retient la longueur maximale et la position fin où elle se termine dans a.
def plus_longue_dyn(a, b):
    n, m = len(a), len(b)
    L = [[0 for j in range(m + 1)] for i in range(n + 1)]
    lmax, fin = 0, 0
    for i in range(1, n + 1):
        for j in range(1, m + 1):
            if a[i - 1] == b[j - 1]:
                L[i][j] = L[i - 1][j - 1] + 1
                if L[i][j] > lmax:
                    lmax, fin = L[i][j], i
    return a[fin - lmax:fin]
plus_longue_dyn("ALGORITHME", "LOGARITHME") renvoie "RITHME". Chaque case se calcule en temps constant à partir de sa voisine en haut à gauche : coût de l’ordre de \(n \times m\), au lieu d’au moins \(n^3\) pour la méthode naïve.
★★ Exercice 11 — Une machine minuscule #
≈ 45 min Chapitres croisés : Calculabilité ; Systèmes sur puce
Une machine très simple n’a qu’un registre x (un entier) et un compteur position qui indique l’instruction à exécuter, en partant de 0. Un programme est une liste d’instructions :
-
("ajoute", k): ajoutekàx, puis passe à l’instruction suivante ; -
("saute_si_nul", c): sixvaut0, va à l’instructionc; sinon passe à la suivante ; -
("saute", c): va à l’instructionc; -
("stop",): arrête la machine.
prog_a = [("saute_si_nul", 3), ("ajoute", -1), ("saute", 0), ("stop",)]
prog_b = [("saute_si_nul", 3), ("ajoute", -2), ("saute", 0), ("stop",)]
-
Dérouler
prog_aavecx = 2au départ : noterpositionetxaprès chaque instruction. Combien d’instructions sont exécutées avantstop? Et pour une valeur de départxpositive quelconque ? -
Que fait
prog_bavecx = 4? avecx = 3? Justifier. -
▶ Écrire une fonction
executer(programme, x, max_pas)qui exécute le programme et renvoie la valeur finale dexs’il atteintstopen au plusmax_pasinstructions, etNonesinon. -
executer(prog_a, 50, 100)renvoieNone, alors queprog_as’arrête. Pourquoi ? Peut-on choisirmax_pasassez grand pour queexecuterréponde juste pour tout programme ? Relier la réponse au problème de l’arrêt. En quoi la fonctionexecuterillustre-t-elle qu’un programme est une donnée ? -
Le programme d’un microcontrôleur répète sans fin « lire les capteurs, décider, commander ». Écrire un programme de cette machine qui ne s’arrête jamais, quelle que soit la valeur de départ de
x. Un programme qui ne s’arrête pas est-il forcément faux ?
Corrigé
1. Avec x = 2 :
| Instruction exécutée | position après |
x après |
|---|---|---|
("saute_si_nul", 3) (\(x \neq 0\)) |
1 | 2 |
("ajoute", -1) |
2 | 1 |
("saute", 0) |
0 | 1 |
("saute_si_nul", 3) (\(x \neq 0\)) |
1 | 1 |
("ajoute", -1) |
2 | 0 |
("saute", 0) |
0 | 0 |
("saute_si_nul", 3) (\(x = 0\)) |
3 | 0 |
La machine atteint stop avec x = 0 après \(7\) instructions. Chaque tour de boucle exécute \(3\) instructions et diminue x de \(1\) : pour une valeur de départ x positive, il y a \(3x + 1\) instructions avant stop.
2. Avec x = 4, x prend les valeurs \(4\), \(2\), \(0\) : la machine s’arrête avec x = 0. Avec x = 3, x prend les valeurs \(3\), \(1\), \(-1\), \(-3\)… : il reste impair, ne vaut jamais \(0\), et la machine ne s’arrête jamais.
3.
def executer(programme, x, max_pas):
    position = 0
    pas = 0
    while programme[position][0] != "stop" and pas < max_pas:
        instr = programme[position]
        if instr[0] == "ajoute":
            x = x + instr[1]
            position = position + 1
        elif instr[0] == "saute_si_nul":
            if x == 0:
                position = instr[1]
            else:
                position = position + 1
        elif instr[0] == "saute":
            position = instr[1]
        pas = pas + 1
    if programme[position][0] == "stop":
        return x
    return None
4. Avec x = 50, prog_a a besoin de \(3 \times 50 + 1 = 151\) instructions, plus que max_pas = 100 : executer abandonne trop tôt. Quelle que soit la valeur choisie pour max_pas, un programme qui s’arrête un peu plus tard sera pris à tort pour un programme qui boucle : executer ne sait pas distinguer « s’arrêtera plus tard » de « ne s’arrêtera jamais ». Et aucun autre programme ne peut le faire pour tous les programmes : c’est le problème de l’arrêt, indécidable. Enfin, executer reçoit le programme comme une simple liste, qu’elle lit et exécute : un programme est une donnée pour un autre programme, exactement comme Python lit et exécute nos fichiers .py.
5. Par exemple [("ajoute", 1), ("saute", 0)] (ou même [("saute", 0)]) : aucune instruction stop n’est jamais atteinte. Un programme qui ne s’arrête pas n’est pas forcément faux : un système embarqué est conçu pour tourner tant qu’il est alimenté. Ce qu’on exige alors, c’est que chaque tour de boucle se termine, pour que le système réagisse à temps.