Exercices#
Diviser pour régner
Mode d’emploi
-
Niveau : ★ échauffement, ★★ classique (niveau bac), ★★★ défi ; les coups de pouce et les corrigés se déplient sous chaque exercice.
-
▶ À programmer et tester en Python (console ou éditeur en ligne).
-
Réflexe « diviser pour régner » : (1) comment diviser en sous-problèmes plus petits ? (2) quelle est la condition d’arrêt ? (3) comment combiner les résultats ?
-
Le tri rapide, le Tim sort et la rotation d’image sont traités dans les TP proposés en fin de chapitre.
-
Usage de l’IA, indiqué sur chaque exercice : aucune ; en appui (déboguer, reformuler, vérifier ; la réponse finale est écrite et comprise par vous) ; l’exercice s’appuie sur une réponse d’IA. Voir la charte d’usage de l’IA.
Comprendre et dérouler#
★ Exercice 1 — Recherche dichotomique à la main #
• essentiel
On cherche dans le tableau trié tab = [3, 8, 12, 19, 25, 31, 40, 42, 55, 60, 71].
-
Donner, dans l’ordre, les valeurs comparées lors de la recherche de
40. Combien de comparaisons ? -
Même question pour la recherche de
7(absent). Comment sait-on qu’il est absent ? -
Sur un tableau trié de \(1000\) valeurs, combien de comparaisons au maximum ? (donner un ordre de grandeur, en justifiant par les divisions par \(2\)).
Coup de pouce
Noter à chaque étape les bornes g et d de la zone de recherche et l’indice du milieu (g + d) // 2, puis ne garder que la moitié où la valeur peut encore se trouver. Pour la question 3 : combien de fois peut-on diviser \(1000\) par \(2\) avant d’arriver à \(1\) ?
Corrigé
Remarque
Plusieurs écritures sont souvent possibles : on donne une version simple.
tab = [3, 8, 12, 19, 25, 31, 40, 42, 55, 60, 71] (indices \(0\) à \(10\) ; on note m = (g + d) // 2).
1. Recherche de 40 :
-
g=0, d=10, m=5:tab[5]=31 < 40\(\rightarrow\)g=6; -
g=6, d=10, m=8:tab[8]=55 > 40\(\rightarrow\)d=7; -
g=6, d=7, m=6:tab[6]=40: trouvé.
Valeurs comparées : 31, 55, 40 \(\rightarrow\) 3 comparaisons.
2. Recherche de 7 (absent) :
-
g=0, d=10, m=5:31 > 7\(\rightarrow\)d=4; -
g=0, d=4, m=2:12 > 7\(\rightarrow\)d=1; -
g=0, d=1, m=0:3 < 7\(\rightarrow\)g=1; -
g=1, d=1, m=1:8 > 7\(\rightarrow\)d=0.
Maintenant g=1 > d=0 : l’intervalle de recherche est vide, donc 7 est absent. Valeurs comparées : 31, 12, 3, 8 \(\rightarrow\) 4 comparaisons.
▷ Erreur fréquente. Garder le milieu dans la zone (g = 5 au lieu de g = 6) : l’élément du milieu vient d’être comparé, on l’exclut. Sinon, la zone peut cesser de rétrécir et la recherche ne s’arrête plus.
3. À chaque comparaison, la zone de recherche est divisée par deux. Partant de \(1000\), on atteint \(1\) en une dizaine d’étapes : \(2^{10} = 1024 > 1000\), donc au plus \(\mathbf{10}\) comparaisons (coût logarithmique \(\log_2 n\)).
★ Exercice 2 — Maximum d’un tableau par diviser pour régner #
• essentiel
Pour trouver le maximum d’un tableau non vide t, on peut procéder ainsi : si t n’a qu’un élément, c’est lui le maximum ; sinon, on coupe t en deux moitiés, on cherche le maximum de chaque moitié, et on garde le plus grand des deux.
def maximum(t):
    if len(t) == 1:                 # condition d'arret
        return ...                  # a completer
    milieu = len(t) // 2
    m_g = maximum(...)              # a completer
    m_d = maximum(...)              # a completer
    if m_g > m_d:
        return m_g
    else:
        return m_d
-
Repérer dans ce code les trois temps : diviser, régner, combiner.
-
▶ Compléter les trois lignes manquantes, puis tester la fonction sur
[4, 9, 2, 7]. -
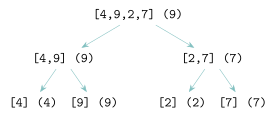
Dessiner l’arbre des appels de
maximum([4, 9, 2, 7])en notant, à côté de chaque appel, la valeur qu’il renvoie.
Coup de pouce
Que vaut le maximum d’un tableau d’un seul élément ? Les deux appels récursifs portent sur les deux moitiés de t, à écrire avec des tranches autour de milieu. Pour l’arbre, noter les valeurs renvoyées en remontant, des feuilles vers la racine.
Corrigé
1. Diviser : milieu = len(t) // 2 coupe t en deux moitiés ; régner : les deux appels récursifs calculent m_g et m_d ; combiner : le if garde le plus grand des deux. La condition d’arrêt est le tableau d’un seul élément.
2. Démarche : condition d’arrêt : un seul élément, c’est le maximum ; les deux appels récursifs portent sur les tranches t[:milieu] et t[milieu:].
def maximum(t):
    if len(t) == 1:                 # condition d'arret
        return t[0]
    milieu = len(t) // 2
    m_g = maximum(t[:milieu])
    m_d = maximum(t[milieu:])
    if m_g > m_d:
        return m_g
    else:
        return m_d
maximum([4, 9, 2, 7]) renvoie 9.
Autre méthode : au lieu de recopier les moitiés avec des tranches, on peut, comme pour la recherche dichotomique du cours, travailler sur la zone t[debut..fin] repérée par deux indices ; aucune liste n’est alors recopiée. Premier appel : maximum_zone(t, 0, len(t) - 1).
def maximum_zone(t, debut, fin):
    if debut == fin:                # condition d'arret : un seul element
        return t[debut]
    milieu = (debut + fin) // 2
    m_g = maximum_zone(t, debut, milieu)
    m_d = maximum_zone(t, milieu + 1, fin)
    if m_g > m_d:
        return m_g
    else:
        return m_d
3. Arbre des appels (valeur renvoyée entre parenthèses) :
★★ Exercice 3 — Tri fusion : l’arbre des appels #
• essentiel
On trie [8, 3, 5, 1, 9, 2] par tri fusion (on coupe à milieu = len(tab) // 2).
-
Dessiner l’arbre de la phase « diviser » (jusqu’aux listes de \(1\) élément).
Coup de pouce
Q1 : chaque liste de longueur au moins \(2\) est coupée en
tab[:milieu]ettab[milieu:]; attention, pour une longueur impaire, la moitié gauche est la plus courte. -
Détailler la remontée : donner chaque liste obtenue par fusion, jusqu’à la liste triée finale.
Coup de pouce
Q2 : lire l’arbre de bas en haut : chaque nœud reçoit la fusion des deux listes triées de ses fils.
-
▶ Compléter les deux appels récursifs de la fonction ci-dessous, puis la tester.
Coup de pouce
Q3 : que faut-il trier récursivement ? Exprimer chacune des deux moitiés avec une tranche de
tabautour demilieu.
def tri_fusion(tab):
    if len(tab) <= 1:
        return tab
    milieu = len(tab) // 2
    gauche = ...                    # a completer
    droite = ...                    # a completer
    return fusion(gauche, droite)   # fusion : cf. cours
Corrigé
1. Phase « diviser » de [8, 3, 5, 1, 9, 2] (coupe à milieu = len // 2) :
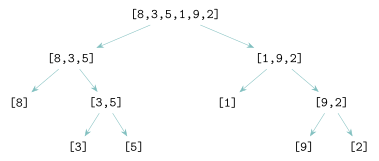
▷ Erreur fréquente. Couper [8, 3, 5] en [8, 3] et [5] : avec milieu = 3 // 2 = 1, la moitié gauche est tab[:1] = [8], la plus courte.
2. Remontée (fusions) :
-
[3]&[5]\(\rightarrow\)[3,5]; puis[8]&[3,5]\(\rightarrow\)[3,5,8]; -
[9]&[2]\(\rightarrow\)[2,9]; puis[1]&[2,9]\(\rightarrow\)[1,2,9]; -
enfin
[3,5,8]&[1,2,9]\(\rightarrow\)[1,2,3,5,8,9].
3. Les deux appels récursifs portent sur les deux moitiés :
def tri_fusion(tab):
    if len(tab) <= 1:
        return tab
    milieu = len(tab) // 2
    gauche = tri_fusion(tab[:milieu])
    droite = tri_fusion(tab[milieu:])
    return fusion(gauche, droite)
★ Exercice 4 — Compter les appels du tri fusion #
On reprend la fonction tri_fusion de l’exercice précédent.
-
Dessiner l’arbre des appels de
tri_fusion([6, 2, 7, 1]). Combien d’appels àtri_fusionen tout (appel initial compris) ? -
Pour une liste de \(8\) éléments, combien d’appels y a-t-il à chaque niveau de l’arbre ? Combien de niveaux sous l’appel initial ? Combien d’appels en tout ?
-
Pour une liste de \(1024 = 2^{10}\) éléments, combien de niveaux de découpe y a-t-il sous l’appel initial ? Quel lien avec \(\log_2\) ?
Coup de pouce
Un appel sur une liste d’au moins deux éléments lance exactement deux appels, sur des listes deux fois plus courtes. Compter niveau par niveau : combien d’appels au niveau suivant pour chaque appel du niveau courant ?
Corrigé
1. [6,2,7,1] appelle [6,2] et [7,1], qui appellent chacun deux listes d’un élément ([6], [2], [7], [1]) : \(1 + 2 + 4 = \mathbf{7}\) appels.
▷ Erreur fréquente. Oublier l’appel initial, ou ne compter que les feuilles : on trouve \(6\) ou \(4\) au lieu de \(7\). Chaque nœud de l’arbre est un appel.
2. Pour \(8\) éléments : \(1\) appel (taille \(8\)), puis \(2\) (taille \(4\)), \(4\) (taille \(2\)), \(8\) (taille \(1\)). Il y a donc 3 niveaux sous l’appel initial et \(1+2+4+8 = \mathbf{15}\) appels en tout.
3. À chaque niveau, la taille est divisée par \(2\) : \(1024 \to 512 \to \dots \to 1\), soit 10 niveaux, et \(10 = \log_2 1024\). Le nombre de niveaux de l’arbre est \(\log_2 n\) : c’est l’origine du facteur \(\log_2 n\) dans le coût \(n\log_2 n\) du tri fusion.
★★ Exercice 5 — Écrire la fusion de deux listes triées #
• essentiel
-
Fusionner à la main les listes triées
[1, 4, 9]et[2, 3, 10, 12]: à chaque étape, noter les deux éléments comparés et celui qui est recopié. Combien de comparaisons ? -
▶ Écrire une fonction
fusion(a, b)qui prend deux listes triées et renvoie une nouvelle liste triée contenant tous leurs éléments, sans utilisersortnisorted. La tester sur l’exemple de la question 1, puis avec une liste vide.Coup de pouce
Q2 : garder un indice par liste. Tant que les deux listes ont encore des éléments, comparer leurs « têtes » et recopier la plus petite. Que reste-t-il à faire quand l’une des deux est épuisée ?
Coup de pouce 2 (début de solution)
Q2 :
resultat = []
i, j = 0, 0
while i < len(a) and j < len(b):
if a[i] <= b[j]:… -
Justifier que le nombre de comparaisons effectuées par
fusion(a, b)est au pluslen(a) + len(b) - 1. Quel est donc le coût de la fusion ?Coup de pouce
Q3 : chaque comparaison est suivie de la recopie d’un élément ; combien d’éléments au plus sont recopiés avant que l’une des listes soit vide ?
Corrigé
1. 1 contre 2 \(\to\) 1 ; 4 contre 2 \(\to\) 2 ; 4 contre 3 \(\to\) 3 ; 4 contre 10 \(\to\) 4 ; 9 contre 10 \(\to\) 9. La première liste est épuisée : on recopie le reste [10, 12]. Résultat [1, 2, 3, 4, 9, 10, 12], en 5 comparaisons.
2. Démarche : un indice par liste ; tant que les deux listes ont encore des éléments, on compare leurs têtes et l’on recopie la plus petite ; à la fin, on recopie le reste de la liste non épuisée.
def fusion(a, b):
    resultat = []
    i, j = 0, 0
    while i < len(a) and j < len(b):
        if a[i] <= b[j]:
            resultat.append(a[i])
            i = i + 1
        else:
            resultat.append(b[j])
            j = j + 1
    return resultat + a[i:] + b[j:]   # recopier le reste
fusion([1, 4, 9], [2, 3, 10, 12]) renvoie [1, 2, 3, 4, 9, 10, 12] ; fusion([], [1, 2]) renvoie [1, 2] (on n’entre pas dans la boucle).
▷ Erreur fréquente. Oublier de recopier la fin de la liste non épuisée (a[i:] ou b[j:]) : sur l’exemple, 10 et 12 disparaîtraient du résultat.
3. Chaque tour de boucle fait une comparaison et recopie un élément. La boucle s’arrête dès qu’une liste est épuisée, donc au plus quand tous les éléments sauf un ont été recopiés : au plus len(a) + len(b) - 1 comparaisons. Le coût de la fusion est linéaire en la taille totale \(n\) = len(a) + len(b).
Vers le bac#
★★ Exercice 6 — Coder un texte avec « diviser pour régner » (d’après Métropole 2025, jour 2) #
≈ 45 min
Pour compresser un texte, on donne aux caractères fréquents un code binaire court. L’algorithme de Shannon-Fano est un « diviser pour régner » :
-
on classe les caractères par effectif décroissant ;
-
diviser : on coupe la liste en deux groupes d’effectif total à peu près égal (fonction
separeci-dessous) ; le premier groupe reçoit le bit"1", le second le bit"0"; -
régner : on recommence sur chaque groupe, jusqu’à ce qu’un groupe ne contienne qu’un caractère (condition d’arrêt).
On représente les données par une liste de couples (caractère, effectif). On admet la fonction separe, qui coupe la liste triée en deux groupes d’effectifs à peu près équilibrés :
def separe(tab):
    total = 0
    for (_, effectif) in tab:
        total = total + effectif
    k = 0
    cumul = tab[0][1]
    while cumul < total / 2:        # on coupe des que le cumul
        k = k + 1                   # atteint la moitie du total
        cumul = cumul + tab[k][1]
    return tab[:k + 1], tab[k + 1:]
On considère le texte dont les effectifs sont : $\(\texttt{tab = [("A", 15), ("B", 7), ("C", 6), ("D", 6), ("E", 5)]}.\)$
-
Que renvoie
separe(tab)? (donner les deux groupes) Quel bit ("1"ou"0") commence alors le code de"A"? celui de"C"?Coup de pouce
Q1 : calculer d’abord l’effectif total, puis cumuler les effectifs dans l’ordre jusqu’à atteindre la moitié de ce total.
-
▶ Compléter la fonction récursive
shannon, qui renvoie le code binaire d’unsymbole:Coup de pouce
Q2 : le code du symbole, c’est le bit de son groupe suivi du code du symbole à l’intérieur de ce groupe : sur quelle liste faire l’appel récursif ?
def shannon(symbole, tab): if len(tab) == 1: # condition d'arret : un seul caractere return "" groupe1, groupe2 = separe(tab) if symbole in [c for (c, _) in groupe1]: return "1" + ... # a completer else: return "0" + ... # a completer -
▶ Vérifier que l’on obtient les codes
A = 11,B = 10,C = 011,D = 010,E = 00. Dérouler à la main le calcul deshannon("C", tab). -
Observer les cinq codes : montrer qu’aucun n’est le début d’un autre. Pourquoi est-ce indispensable pour décoder un texte sans ambiguïté ?
-
En quoi cet algorithme relève-t-il de « diviser pour régner » ? Identifier les trois temps.
-
Terminaison : justifier que la fonction
shannons’arrête toujours (quel « variant » diminue strictement à chaque appel récursif ?).Coup de pouce
Q6 : comparer la longueur de
tabà celle du groupe passé à l’appel récursif : chacun des deux groupes peut-il être vide ? -
▶ Écrire une fonction
encode_shannon(texte, tab)qui renvoie le texte codé : la concaténation des codesshannonde chacun de ses caractères. Exemple :encode_shannon("CAD", tab)renvoie"011"+"11"+"010" = "01111010".Coup de pouce
Q7 : partir d’une chaîne vide et la compléter en parcourant le texte caractère par caractère.
Remarque
Ce sujet (Métropole 2025, jour 2) montre que « diviser pour régner » ne sert pas qu’à trier : il structure aussi la compression des données.
Corrigé
Barème indicatif (sur 6) : Q1 : 0,75 ; Q2 : 1,25 ; Q3 : 1 ; Q4 : 0,75 ; Q5 : 0,75 ; Q6 : 1 ; Q7 : 0,5
1. L’effectif total est \(15+7+6+6+5 = 39\), et \(39/2 = 19{,}5\). Le cumul atteint \(19{,}5\) dès "B" (\(15+7 = 22\)). Donc $\(\texttt{separe(tab)} = \big(\,[("A",15),("B",7)]\ ,\ [("C",6),("D",6),("E",5)]\,\big).\)$ "A" est dans le premier groupe \(\rightarrow\) son code commence par "1" ; "C" est dans le second \(\rightarrow\) son code commence par "0".
2. On préfixe le bit puis on recommence sur le bon groupe :
def shannon(symbole, tab):
    if len(tab) == 1:
        return ""
    groupe1, groupe2 = separe(tab)
    if symbole in [c for (c, _) in groupe1]:
        return "1" + shannon(symbole, groupe1)
    else:
        return "0" + shannon(symbole, groupe2)
3. Codes obtenus : A = 11, B = 10, C = 011, D = 010, E = 00. Déroulement de shannon("C", tab) :
-
tab\(\rightarrow\) groupes[A,B]et[C,D,E];Cest dans le second \(\rightarrow\)"0" +shannon("C", [C,D,E]); -
[C,D,E]: total \(17\), coupe aprèsC,D(cumul \(12 \ge 8{,}5\)) \(\rightarrow\) groupes[C,D]et[E];Cdans le premier \(\rightarrow\)"1" +shannon("C", [C,D]); -
[C,D]: total \(12\), coupe aprèsC(cumul \(6 \ge 6\)) \(\rightarrow\) groupes[C]et[D];Cdans le premier \(\rightarrow\)"1" +shannon("C", [C]); -
[C]: un seul caractère \(\rightarrow\)"".
En remontant : "1" + "" = "1", puis "1" + "1" = "11", puis "0" + "11" = "011". D’où C = 011.
4. Les codes 11, 10, 011, 010, 00 forment un code préfixe : aucun n’est le début d’un autre. C’est indispensable au décodage : en lisant le texte codé bit à bit, dès qu’on reconnaît un code on sait qu’il est complet (il ne peut pas être le début d’un code plus long), donc le découpage en symboles est sans ambiguïté.
5. Trois temps de « diviser pour régner » : diviser = couper la liste en deux groupes d’effectifs à peu près équilibrés (separe) ; régner = appeler récursivement shannon sur le groupe contenant le symbole ; combiner = préfixer le bit "1" ou "0" au code renvoyé.
6. Terminaison. Le variant est len(tab) (nombre de caractères). separe renvoie deux groupes non vides dont la réunion est tab (le premier contient au moins tab[0] ; comme la liste est triée par effectifs décroissants, le dernier effectif vaut au plus la moitié du total, donc le cumul atteint la moitié avant le dernier caractère et le second groupe n’est pas vide — sans ce tri, separe([("A", 1), ("B", 3)]) renverrait un second groupe vide et shannon("A", ...) ne s’arrêterait pas) ; le groupe sur lequel on récurse contient donc strictement moins de caractères que tab. Cet entier positif décroît d’au moins \(1\) à chaque appel et atteint \(1\) (cas d’arrêt) : la fonction s’arrête toujours.
7. Démarche : une chaîne vide que l’on complète en parcourant le texte : à chaque caractère, on ajoute son code shannon.
def encode_shannon(texte, tab):
    code = ""
    for c in texte:
        code = code + shannon(c, tab)
    return code
Ainsi encode_shannon("CAD", tab) vaut "011" + "11" + "010" = "01111010".
★★ Exercice 7 — Le tri de Stooge (d’après Amérique du Nord 2024, jour 2) #
≈ 45 min
On se penche sur un algorithme pour trier un tableau appelé le tri de Stooge. Pour trier les éléments situés entre les indices \(i\) et \(j\), où \(i < j\), dans un tableau t par ce tri, on procède ainsi :
-
si les éléments d’indice \(i\) et \(j\) sont mal placés, on les échange ;
-
s’il y a au moins trois éléments entre les indices \(i\) et \(j\) :
-
on trie les deux premiers tiers du tableau avec cette méthode ;
-
on trie les deux derniers tiers du tableau avec cette méthode ;
-
on trie à nouveau les deux premiers tiers du tableau avec cette méthode.
Pour réaliser ce découpage en tiers, on considère l’entier k défini par l’expression (j - i + 1) // 3, et on considère les indices intermédiaires i + k et j - k.
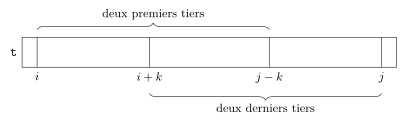
Voici le code partiel du tri de Stooge en Python, qui trie les éléments d’un tableau par ordre croissant :
def triStooge(tab, i, j):
    if tab[i] > tab[j]:
        echange(tab, i, j)
    if (j - i) > 1:
        k = (j - i + 1) // 3
        triStooge(*\textit{(...)}*)
        triStooge(*\textit{(...)}*)
        triStooge(*\textit{(...)}*)
-
▶ Écrire la fonction
echange(tab, i, j)qui prend en arguments une liste Pythontabet deux indicesi,j, et réalise sur place l’échange des valeurs detabà ces indices. La fonction ne renvoie rien. -
▶ Finaliser le programme précédent en complétant les lignes 6, 7 et 8.
Coup de pouce
Q2 : relire la figure : entre quels indices se trouvent les « deux premiers tiers » ? les « deux derniers tiers » ? Dans quel ordre la méthode les trie-t-elle ?
-
Indiquer, en le justifiant, si cet algorithme est itératif ou récursif.
Soit l’appel triStooge(A, 0, 5) avec A = [5, 6, 4, 2, 3, 1].
- Déterminer la valeur prise par
klors de ce premier appel. Une justification est attendue.
La figure ci-dessous présente l’arbre (incomplet) des appels récursifs effectués depuis l’appel triStooge(A, 0, 5).
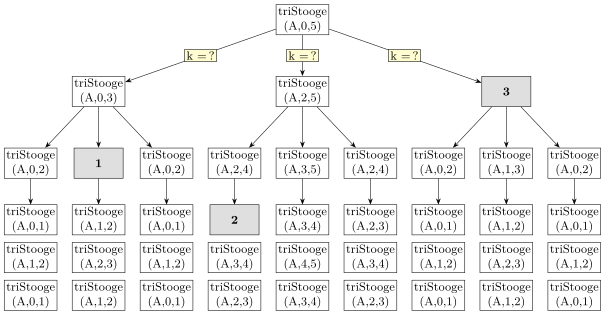
Arbre des appels récursifs pour triStooge(A, 0, 5) (au dernier niveau, les trois appels issus d’un même nœud sont empilés verticalement).
-
Dénombrer les appels récursifs effectués lors du tri, sans compter l’appel initial.
Coup de pouce
Q5 : combien d’appels un nœud qui n’est pas une feuille déclenche-t-il ? Compter niveau par niveau.
-
Déterminer les appels effectués dans les cases 1, 2 et 3 de cet arbre des appels.
-
Dans cette question,
A = [5, 6, 4, 2]. Recopier le tableau ci-dessous et le compléter (remplacer les??).Coup de pouce
Q7 : calculer
kpour l’appeltriStooge(A,0,3), en déduire ses trois appels ; la valeur « après » d’une ligne est la valeur « avant » de la suivante.Appel Valeur de A avant l’appel Valeur de A après l’appel triStooge(A,0,3)[5, 6, 4, 2]????[2, 6, 4, 5]??triStooge(A,1,3)[2, 4, 6, 5]????[2, 4, 5, 6][2, 4, 5, 6]
On montre que le coût en temps dans le pire des cas du tri de Stooge est de l’ordre de \(n^{e}\), avec \(e\) environ égal à \(\frac{8}{3}\).
- Donner un algorithme de tri dont le coût est strictement meilleur.
Corrigé
Barème indicatif (sur 6) : Q1 : 0,5 ; Q2 : 1 ; Q3 : 0,5 ; Q4 : 0,5 ; Q5 : 1,25 ; Q6 : 0,75 ; Q7 : 1 ; Q8 : 0,5
1. Échange sur place (la liste est modifiée, rien n’est renvoyé) :
def echange(tab, i, j):
    tab[i], tab[j] = tab[j], tab[i]
2. Deux premiers tiers : de i à j - k ; deux derniers tiers : de i + k à j :
def triStooge(tab, i, j):
    if tab[i] > tab[j]:
        echange(tab, i, j)
    if (j - i) > 1:
        k = (j - i + 1) // 3
        triStooge(tab, i, j - k)
        triStooge(tab, i + k, j)
        triStooge(tab, i, j - k)
Avec A = [5, 6, 4, 2, 3, 1], triStooge(A, 0, 5) donne bien [1, 2, 3, 4, 5, 6].
3. L’algorithme est récursif : la fonction triStooge s’appelle elle-même (trois fois) dans son propre corps. La condition d’arrêt (cas de base) est j - i <= 1 : il reste au plus deux éléments, et un simple échange suffit.
4. k = (5 - 0 + 1) // 3 = 6 // 3 = 2. Le premier appel porte sur \(6\) éléments, chaque tiers en contient \(2\).
▷ Erreur fréquente. Calculer k = (5 - 0) // 3 = 1 : la formule compte les éléments de l’indice i à l’indice j inclus, soit j - i + 1 = 6, d’où k = 2.
5. Niveau 1 : \(3\) appels ; niveau 2 : \(3 \times 3 = 9\) appels ; niveau 3 : \(9 \times 3 = 27\) appels (sur deux ou trois éléments, ces appels n’ont plus d’enfants lorsque j - i = 1). Total : \(3 + 9 + 27 = \mathbf{39}\) appels récursifs.
6. Sur les arêtes partant de la racine, k = 2 ; sur celles partant du niveau 1 (sous-tableaux de \(4\) éléments), k = 1.
-
case 1 : deuxième appel de
triStooge(A,0,3)(k = 1) \(\rightarrow\)triStooge(A,1,3); -
case 2 : premier appel de
triStooge(A,2,4)(k = 1) \(\rightarrow\)triStooge(A,2,3); -
case 3 : troisième appel de la racine, identique au premier \(\rightarrow\)
triStooge(A,0,3).
7. Avec A = [5, 6, 4, 2] : l’appel triStooge(A,0,3) échange d’abord 5 et 2, puis k = 1 et il lance triStooge(A,0,2), triStooge(A,1,3), triStooge(A,0,2).
| Appel | A avant l’appel | A après l’appel |
|---|---|---|
triStooge(A,0,3) |
[5, 6, 4, 2] |
[2, 4, 5, 6] |
triStooge(A,0,2) |
[2, 6, 4, 5] |
[2, 4, 6, 5] |
triStooge(A,1,3) |
[2, 4, 6, 5] |
[2, 4, 5, 6] |
triStooge(A,0,2) |
[2, 4, 5, 6] |
[2, 4, 5, 6] |
8. Le tri fusion, de coût \(n \log_2 n\) dans le pire des cas, est strictement meilleur que \(n^{8/3}\) (et même les tris par insertion ou par sélection, de coût \(n^2\), font mieux que le tri de Stooge).
★★★ Exercice 8 — L’élément absolument majoritaire (d’après Asie 2024, jour 2) #
≈ 60 min
On cherche à déterminer, s’il existe, l’élément absolument majoritaire d’une liste : un élément qui apparaît dans strictement plus de la moitié des emplacements de la liste.
Par exemple, la liste [1, 4, 1, 6, 1, 7, 2, 1, 1] admet 1 comme élément absolument majoritaire, car il apparaît \(5\) fois sur \(9\) éléments. En revanche, la liste [1, 4, 6, 1, 7, 2, 1, 1] n’admet pas d’élément absolument majoritaire : le plus fréquent est 1, mais il n’apparaît que \(4\) fois sur \(8\), ce qui ne fait pas plus que la moitié.
- Déterminer les effectifs possibles d’un élément absolument majoritaire dans une liste de taille \(10\).
Partie A — Calcul des effectifs sans dictionnaire. On peut déterminer l’éventuel élément absolument majoritaire d’une liste en calculant l’effectif de chacun de ses éléments.
-
▶ Écrire une fonction
effectifqui prend en paramètres une valeurvalet une listelstet qui renvoie le nombre d’apparitions devaldanslst. Il ne faut pas utiliser la méthodecount.Coup de pouce
Q2 : un compteur initialisé à \(0\) et une boucle sur les éléments de
lst. -
Déterminer le nombre de comparaisons effectuées par l’appel
effectif(1, [1, 4, 1, 6, 1, 7, 2, 1, 1]). -
▶ En utilisant la fonction
effectif, écrire une fonctionmajo_abs1qui prend en paramètre une listelstet qui renvoie son élément absolument majoritaire s’il existe,Nonesinon. -
Déterminer le nombre de comparaisons effectuées par l’appel
majo_abs1([1, 4, 1, 6, 1, 7, 2, 1, 1]).
Partie B — Calcul des effectifs dans un dictionnaire. Un autre algorithme consiste à stocker l’effectif partiel de chaque élément déjà rencontré dans un dictionnaire.
-
▶ Recopier et compléter les lignes 3, 4, 5 et 7 de la fonction
eff_dicosuivante, qui prend en paramètre une listelstet renvoie un dictionnaire dont les clés sont les éléments delstet les valeurs les effectifs de ces éléments danslst.def eff_dico(lst): dico_sortie = {} for (*\textit{.........}*) : if (*\textit{...}*) in dico_sortie: (*\textit{...}*) else: (*\textit{...}*) return dico_sortie -
▶ En utilisant la fonction
eff_dico, écrire une fonctionmajo_abs2qui prend en paramètre une listelstet qui renvoie son élément absolument majoritaire s’il existe,Nonesinon.
Partie C — Par la méthode « diviser pour régner ». Un dernier algorithme consiste à partager la liste en deux listes, à déterminer les éventuels éléments absolument majoritaires de chacune des deux listes, puis à combiner les résultats pour obtenir, s’il existe, l’élément absolument majoritaire de la liste initiale. On considère lst une liste de taille \(n\).
- Déterminer l’élément absolument majoritaire de
lstsi \(n = 1\). C’est le cas de base (condition d’arrêt).
On suppose que l’on a partagé lst en deux listes : lst1 = lst[:n//2] (les n//2 premiers éléments de lst) et lst2 = lst[n//2:] (les autres éléments).
-
Si ni
lst1nilst2n’admet d’élément absolument majoritaire, expliquer pourquoilstn’admet pas d’élément absolument majoritaire.Coup de pouce
Q9 : raisonner par l’absurde : si un élément apparaît au plus la moitié des fois dans
lst1et danslst2, que dire de son effectif danslst? -
Si
lst1admet un élément absolument majoritairemaj1, donner un algorithme pour vérifier simaj1est l’élément absolument majoritaire delst. -
▶ Recopier et compléter les lignes 4, 11, 13, 15 et 17 de la fonction récursive
majo_abs3qui implémente l’algorithme précédent. On pourra utiliser la fonctioneffectifde la question 2.Coup de pouce
Q11 : un candidat majoritaire d’une moitié doit être recompté dans la liste entière
lst, pas seulement dans sa moitié.Coup de pouce 2 (début de solution)
Q11, ligne 4 : une liste d’un seul élément a cet élément pour majoritaire,
return lst[0]. Ligne 11 :eff = effectif(maj_g, lst).def majo_abs3(lst): n = len(lst) if n == 1: return (*\textit{...}*) else: lst_g = lst[:n//2] lst_d = lst[n//2:] maj_g = majo_abs3(lst_g) maj_d = majo_abs3(lst_d) if maj_g is not None: eff = (*\textit{......}*) if eff > n/2: return (*\textit{...}*) if maj_d is not None: eff = (*\textit{......}*) if eff > n/2: return (*\textit{...}*)
Corrigé
Barème indicatif (sur 8) : Q1 : 0,5 ; Q2 : 0,75 ; Q3 : 0,5 ; Q4 : 1 ; Q5 : 0,75 ; Q6 : 0,75 ; Q7 : 0,75 ; Q8 : 0,5 ; Q9 : 0,75 ; Q10 : 0,5 ; Q11 : 1,25
1. Il faut apparaître strictement plus de \(10/2 = 5\) fois : effectifs possibles \(6, 7, 8, 9\) ou \(10\).
2.
def effectif(val, lst):
    n = 0
    for x in lst:
        if x == val:
            n = n + 1
    return n
3. Chaque élément de la liste est comparé une fois à val : 9 comparaisons.
4.
def majo_abs1(lst):
    for val in lst:
        if effectif(val, lst) > len(lst) / 2:
            return val
    return None
5. Le premier élément testé est 1, dont l’effectif \(5\) dépasse \(9/2\) : la fonction renvoie 1 dès le premier tour. Un seul appel à effectif, soit 9 comparaisons entre éléments (plus la comparaison 5 > 4.5). Dans le pire des cas (pas d’élément majoritaire), il y aurait \(n\) appels à effectif, soit \(n^2\) comparaisons.
6.
def eff_dico(lst):
    dico_sortie = {}
    for elt in lst:
        if elt in dico_sortie:
            dico_sortie[elt] = dico_sortie[elt] + 1
        else:
            dico_sortie[elt] = 1
    return dico_sortie
Par exemple eff_dico([1, 4, 1, 6, 1, 7, 2, 1, 1]) renvoie {1: 5, 4: 1, 6: 1, 7: 1, 2: 1}.
7.
def majo_abs2(lst):
    dico = eff_dico(lst)
    for cle in dico:
        if dico[cle] > len(lst) / 2:
            return cle
    return None
8. Si \(n = 1\), l’unique élément lst[0] apparaît \(1 > 1/2\) fois : c’est l’élément absolument majoritaire. Le cas de base renvoie lst[0].
9. Notons \(n_1\) et \(n_2\) les tailles de lst1 et lst2 (\(n_1 + n_2 = n\)). Si un élément x était absolument majoritaire dans lst, il ne le serait dans aucune des deux moitiés, donc il apparaîtrait au plus \(n_1/2\) fois dans lst1 et au plus \(n_2/2\) fois dans lst2, soit au plus \((n_1 + n_2)/2 = n/2\) fois dans lst : ce n’est pas strictement plus que la moitié. Contradiction : lst n’a pas d’élément absolument majoritaire.
10. Compter les apparitions de maj1 dans toute la liste lst (fonction effectif) et comparer à \(n/2\) : si effectif(maj1, lst) > n/2, alors maj1 est l’élément absolument majoritaire de lst ; sinon, il ne l’est pas (et il faut examiner l’éventuel majoritaire de lst2).
11. Si aucun des deux candidats ne convient, la fonction atteint sa fin sans return et renvoie donc None (question 9).
def majo_abs3(lst):
    n = len(lst)
    if n == 1:
        return lst[0]
    else:
        lst_g = lst[:n//2]
        lst_d = lst[n//2:]
        maj_g = majo_abs3(lst_g)
        maj_d = majo_abs3(lst_d)
        if maj_g is not None:
            eff = effectif(maj_g, lst)
            if eff > n/2:
                return maj_g
        if maj_d is not None:
            eff = effectif(maj_d, lst)
            if eff > n/2:
                return maj_d
majo_abs3([1, 4, 1, 6, 1, 7, 2, 1, 1]) renvoie 1 et majo_abs3([1, 4, 6, 1, 7, 2, 1, 1]) renvoie None. Les trois temps : diviser (couper en deux moitiés), régner (deux appels récursifs), combiner (compter les deux candidats dans toute la liste).
★★ Exercice 9 — Les deux points les plus proches (d’après Polynésie 2023, jour 1) #
≈ 60 min
L’objectif est de trouver les deux points les plus proches dans un nuage de points dont on connaît les coordonnées dans un repère orthogonal. On rappelle que la distance entre deux points \(A(x_A ; y_A)\) et \(B(x_B ; y_B)\) est donnée par la formule : $\(AB = \sqrt{(x_B - x_A)^2 + (y_B - y_A)^2}.\)$ Les coordonnées d’un point sont stockées dans un tuple de deux nombres réels. Le nuage de points est représenté en Python par une liste de tuples de taille \(n\), \(n\) étant le nombre total de points. On suppose qu’il n’y a pas de points confondus et qu’il y a au moins deux points dans le nuage. Pour calculer la racine carrée, on utilise la fonction sqrt du module math :
>>> from math import sqrt
>>> sqrt(16)
4.0
-
Questions générales.
-
Donner le rôle de l’instruction
from math import sqrt. -
Expliquer le résultat suivant :
>>> 0.1 + 0.2 == 0.3 False -
Expliquer l’erreur suivante :
>>> point_A = (3, 4)
>>> point_A[0]
3
>>> point_A[0] = 2
Traceback (most recent call last):
    File "<console>", line 1, in <module>
TypeError: 'tuple' object does not support item assignment
-
-
On définit la classe
Segmentci-dessous :from math import sqrt class Segment: def __init__(self, point1, point2): self.p1 = point1 self.p2 = point2 self.longueur = (*\textit{..............}*) # a completer- Recopier et compléter la ligne 6 du constructeur de la classe
Segment.
La fonction
liste_segmentsci-dessous prend en paramètre une liste de points et renvoie une liste contenant les objetsSegmentqu’il est possible de construire à partir de ces points. Les segments \([AB]\) et \([BA]\) étant confondus, on n’ajoute qu’un seul objet dans la liste.def liste_segments(liste_points): n = len(liste_points) segments = [] for i in range((*\textit{...............}*)): for j in range((*\textit{...............}*), n): # On construit le segment a partir des points i et j. seg = (*\textit{..............................}*) segments.append(seg) # On l'ajoute a la liste return segments-
▶ Recopier la fonction sans les commentaires et compléter le code manquant.
Coup de pouce
Q2 b : pour ne construire \([AB]\) qu’une fois, l’indice
jdoit toujours être strictement plus grand quei; que doit valoiriau plus ? -
Donner, en fonction de \(n\), la longueur de la liste
segments. Le résultat peut être laissé sous la forme d’une somme. -
Donner, en fonction de \(n\), la complexité en temps de la fonction
liste_segments.
- Recopier et compléter la ligne 6 du constructeur de la classe
-
On veut maintenant écrire la fonction de recherche des deux points les plus proches par la méthode diviser pour régner. On dispose de deux fonctions
moitie_gauche(respectivementmoitie_droite) qui prennent en paramètre une liste et renvoient chacune une nouvelle liste contenant la moitié gauche (respectivement droite) de la liste de départ. Si le nombre d’éléments est impair, l’élément du centre se trouve dans la partie gauche.>>> liste = [1, 2, 3, 4] >>> moitie_gauche(liste) [1, 2] >>> moitie_droite(liste) [3, 4] >>> liste = [1, 2, 3, 4, 5] >>> moitie_gauche(liste) [1, 2, 3] >>> moitie_droite(liste) [4, 5]▶ Écrire la fonction
plus_court_segmentqui prend en paramètre une liste d’objetsSegmentet renvoie l’objetSegmentdont la longueur est la plus petite. On procédera de la façon suivante :-
tester si le cas de base (condition d’arrêt) est atteint, c’est-à-dire si la liste contient un seul segment ;
-
découper la liste en deux listes de tailles égales (à une unité près) ;
-
appeler récursivement la fonction pour rechercher le minimum dans chacune des deux listes ;
-
comparer les deux valeurs récupérées et renvoyer la plus petite des deux.
Coup de pouce
Q3 : on compare les segments par leur attribut
longueur, mais on renvoie l’objetSegmentlui-même.Coup de pouce 2 (début de solution)
Q3 :
def plus_court_segment(segments):
if len(segments) == 1:
return segments[0]
seg_g = plus_court_segment(moitie_gauche(segments))… -
-
On considère les trois points \(A(3 ; 4)\), \(B(2 ; 3)\) et \(C(-3 ; -1)\).
-
Donner l’instruction Python permettant de construire la variable
nuage_pointscontenant les trois points \(A\), \(B\) et \(C\). -
▶ En utilisant les fonctions de l’exercice, écrire les instructions Python qui affichent les coordonnées des deux points les plus proches du nuage de points
nuage_points.
-
Corrigé
Barème indicatif (sur 8) : Q1.a : 0,25 ; Q1.b : 0,5 ; Q1.c : 0,5 ; Q2.a : 0,5 ; Q2.b : 1,25 ; Q2.c : 0,75 ; Q2.d : 0,75 ; Q3 : 2 ; Q4.a : 0,5 ; Q4.b : 1
1. a) Elle importe la fonction sqrt (racine carrée) du module math, pour pouvoir l’utiliser directement sous le nom sqrt.
1. b) Les nombres flottants sont stockés en binaire avec un nombre limité de bits : 0.1, 0.2 et 0.3 n’ont pas d’écriture binaire finie et sont arrondis. La somme vaut en réalité 0.30000000000000004, différente de l’arrondi de 0.3. On ne doit donc jamais tester l’égalité de deux flottants avec ==.
1. c) Un tuple est non modifiable (immuable) : on peut lire point_A[0], mais pas lui affecter une nouvelle valeur, d’où la TypeError.
2. a) Ligne 6 :
self.longueur = sqrt((point2[0] - point1[0])**2 + (point2[1] - point1[1])**2)
2. b) Démarche : on associe chaque point i uniquement aux points j situés après lui, pour ne pas construire \([BA]\) en plus de \([AB]\) :
def liste_segments(liste_points):
    n = len(liste_points)
    segments = []
    for i in range(n - 1):
        for j in range(i + 1, n):
            seg = Segment(liste_points[i], liste_points[j])
            segments.append(seg)
    return segments
▷ Erreur fréquente. Faire partir j de 0 : on construit alors \([AB]\) et \([BA]\), et même des « segments » \([AA]\) de longueur nulle, qui fausseraient la recherche du plus court.
2. c) Le point d’indice \(0\) donne \(n-1\) segments, le point d’indice \(1\) en donne \(n-2\), …, le point d’indice \(n-2\) en donne \(1\) : la longueur vaut \((n-1) + (n-2) + \dots + 1 = \dfrac{n(n-1)}{2}\).
2. d) On construit \(\dfrac{n(n-1)}{2}\) segments, chacun en temps constant : la complexité est quadratique, en \(O(n^2)\).
3. Démarche : condition d’arrêt : un seul segment ; sinon, deux appels récursifs sur les deux moitiés de la liste, puis on garde le segment de plus petite longueur (on renvoie l’objet, pas sa longueur).
def plus_court_segment(segments):
    if len(segments) == 1:                 # condition d'arret
        return segments[0]
    seg_g = plus_court_segment(moitie_gauche(segments))
    seg_d = plus_court_segment(moitie_droite(segments))
    if seg_g.longueur <= seg_d.longueur:
        return seg_g
    else:
        return seg_d
Chaque appel réduit strictement la taille de la liste (les deux moitiés sont non vides dès qu’il y a au moins deux segments), ce qui garantit la terminaison.
4. a) nuage_points = [(3, 4), (2, 3), (-3, -1)]
4. b) Démarche : on construit la liste de tous les segments, on cherche le plus court par diviser pour régner, puis on affiche ses deux extrémités.
segments = liste_segments(nuage_points)
seg = plus_court_segment(segments)
print(seg.p1, seg.p2)
Affichage obtenu : (3, 4) (2, 3) : les points \(A\) et \(B\), à distance \(\sqrt{2} \approx 1{,}41\).
★★★ Exercice 10 — Comparer deux classements (sujet maison, façon bac) #
≈ 60 min
Cet exercice n’est pas un sujet officiel : il a été écrit au format du bac pour s’entraîner.
Une plateforme d’écoute musicale veut mesurer à quel point le goût d’un auditeur s’écarte du classement officiel des meilleures ventes. Les chansons sont désignées par leur rang officiel (\(1\) pour la plus vendue, \(2\) pour la suivante, etc.). Le classement personnel d’un auditeur est la liste de ces rangs, dans l’ordre où il les préfère. Par exemple, l’auditeur dont le classement est [2, 4, 1, 3, 5] préfère la chanson de rang officiel \(2\), puis celle de rang \(4\), etc.
On appelle inversion d’une liste t tout couple d’indices (i, j) tel que i < j et t[i] > t[j] : deux chansons que l’auditeur range dans l’ordre inverse du classement officiel. Plus il y a d’inversions, plus l’auditeur est en désaccord avec le classement officiel.
Partie A — Une méthode directe.
-
Donner les inversions de
[2, 4, 1, 3, 5](sous la forme de couples de valeurs). Quel classement de cinq chansons ne contient aucune inversion ? Lequel en contient le plus, et combien ? -
▶ Écrire une fonction
inversions_naif(t)qui renvoie le nombre d’inversions de la listeten testant tous les couples d’indices(i, j)aveci < j.Coup de pouce
Q2 : deux boucles imbriquées, la seconde commençant juste après l’indice de la première.
-
Donner, en fonction de la longueur \(n\) de la liste
t, le nombre de comparaisonst[i] > t[j]effectuées par la fonctioninversions_naif. Quel est le coût de cette fonction ? Estimer ce nombre pour une liste d’un million de chansons.
Partie B — Par la méthode « diviser pour régner ». On coupe la liste t en deux moitiés gauche = t[:milieu] et droite = t[milieu:], avec milieu = len(t) // 2. Une inversion de t est alors soit une inversion de gauche, soit une inversion de droite, soit une inversion croisée : un couple formé d’un élément a de gauche et d’un élément b de droite avec a > b.
-
On prend
t = [5, 2, 6, 1, 4, 3]. Donnergaucheetdroite, puis compter les inversions degauche, celles dedroiteet les inversions croisées. En déduire le nombre d’inversions det. -
Le nombre d’inversions croisées ne change pas si l’on trie chacune des deux moitiés (justifier brièvement). On suppose donc
gaucheetdroitetriées, et on les fusionne comme dans le tri fusion. Au moment où l’on placedroite[j]dans le résultat parce quedroite[j] < gauche[i], justifier quedroite[j]forme une inversion croisée avec exactementlen(gauche) - iéléments degauche.Coup de pouce
Q5 :
gaucheest triée : comparerdroite[j]àgauche[i],gauche[i+1], … D’autre part, les élémentsgauche[0], …,gauche[i-1]déjà placés sont-ils plus grands ou plus petits quedroite[j]? -
▶ Recopier et compléter la fonction
fusion_compte, qui renvoie la liste fusionnée et le nombre d’inversions croisées.def fusion_compte(gauche, droite): resultat = [] croisees = 0 i = j = 0 while i < len(gauche) and j < len(droite): if gauche[i] <= droite[j]: resultat.append(gauche[i]) i = i + 1 else: resultat.append(droite[j]) croisees = ... # a completer j = j + 1 resultat = resultat + gauche[i:] resultat = resultat + droite[j:] return ... # a completer -
▶ Recopier et compléter la fonction récursive
tri_compte, qui renvoie la listettriée et son nombre d’inversions. Identifier dans ce code les trois temps « diviser », « régner » et « combiner ».Coup de pouce
Q7 : le nombre total d’inversions est la somme de trois nombres : relire l’introduction de la Partie B.
Coup de pouce 2 (début de solution)
Q7 : condition d’arrêt : une liste d’au plus un élément est triée et n’a aucune inversion,
return t, 0. Puisgauche, inv_g = tri_compte(t[:milieu]).def tri_compte(t): if len(t) <= 1: # condition d'arret return ... # a completer milieu = len(t) // 2 gauche, inv_g = ... # a completer droite, inv_d = ... # a completer fusionnee, inv_c = fusion_compte(gauche, droite) return ... # a completer -
Dérouler l’appel
tri_compte([3, 1, 2]): donner chaque appel récursif et la valeur qu’il renvoie. -
Justifier que
tri_comptese termine. Le coût detri_compteest du même ordre que celui du tri fusion : lequel ? Comparer avec la Partie A pour un million de chansons (on prendra \(\log_2(10^6) \approx 20\)).
Corrigé
Barème indicatif (sur 8) : Q1 : 0,75 ; Q2 : 1 ; Q3 : 1 ; Q4 : 0,75 ; Q5 : 0,75 ; Q6 : 1,25 ; Q7 : 1 ; Q8 : 0,5 ; Q9 : 1
1. Dans [2, 4, 1, 3, 5], les couples rangés « à l’envers » sont \((2, 1)\), \((4, 1)\) et \((4, 3)\) : 3 inversions. Le classement [1, 2, 3, 4, 5] (identique au classement officiel) n’en a aucune. Le classement [5, 4, 3, 2, 1] a le maximum : tous les couples sont inversés, soit \(4 + 3 + 2 + 1 = \mathbf{10}\) inversions.
2.
def inversions_naif(t):
    nb = 0
    for i in range(len(t)):
        for j in range(i + 1, len(t)):
            if t[i] > t[j]:
                nb = nb + 1
    return nb
inversions_naif([2, 4, 1, 3, 5]) renvoie 3.
3. Pour i = 0, on fait \(n - 1\) comparaisons, pour i = 1, \(n - 2\), …, pour i = n - 1, aucune : au total \((n-1) + (n-2) + \dots + 1 = \dfrac{n(n-1)}{2}\) comparaisons. Le coût est quadratique (de l’ordre de \(n^2\)). Pour \(n = 10^6\) : \(\dfrac{10^6\times(10^6-1)}{2} \approx 5\times 10^{11}\) comparaisons.
4. milieu = 3, gauche = [5, 2, 6], droite = [1, 4, 3].
-
inversions de
gauche: \((5, 2)\), soit \(1\) ; -
inversions de
droite: \((4, 3)\), soit \(1\) ; -
inversions croisées : \(5\) est plus grand que \(1, 4, 3\) ; \(2\) que \(1\) ; \(6\) que \(1, 4, 3\) : \(3 + 1 + 3 = 7\).
Total : \(1 + 1 + 7 = \mathbf{9}\) inversions (inversions_naif([5, 2, 6, 1, 4, 3]) renvoie bien 9).
5. Une inversion croisée ne dépend que des valeurs présentes dans chaque moitié (un élément de gauche plus grand qu’un élément de droite), pas de leur ordre à l’intérieur de la moitié : trier gauche et droite ne change donc pas leur nombre. Si droite[j] < gauche[i], comme gauche est triée, on a aussi droite[j] < gauche[i] <= gauche[i+1] <= ... <= gauche[len(gauche)-1] : droite[j] est plus petit que tous les éléments restants de gauche, soit len(gauche) - i éléments. Les éléments gauche[0], …, gauche[i-1], déjà placés, sont <= droite[j] : ils ne forment pas d’inversion avec lui.
6.
def fusion_compte(gauche, droite):
    resultat = []
    croisees = 0
    i = j = 0
    while i < len(gauche) and j < len(droite):
        if gauche[i] <= droite[j]:
            resultat.append(gauche[i])
            i = i + 1
        else:
            resultat.append(droite[j])
            croisees = croisees + len(gauche) - i
            j = j + 1
    resultat = resultat + gauche[i:]
    resultat = resultat + droite[j:]
    return resultat, croisees
Par exemple fusion_compte([2, 5, 6], [1, 3, 4]) renvoie ([1, 2, 3, 4, 5, 6], 7) : on retrouve les \(7\) inversions croisées de la question 4.
7.
def tri_compte(t):
    if len(t) <= 1:                         # condition d'arret
        return t, 0
    milieu = len(t) // 2
    gauche, inv_g = tri_compte(t[:milieu])
    droite, inv_d = tri_compte(t[milieu:])
    fusionnee, inv_c = fusion_compte(gauche, droite)
    return fusionnee, inv_g + inv_d + inv_c
Diviser : couper t en deux moitiés (t[:milieu] et t[milieu:]) ; régner : les deux appels récursifs, qui trient chaque moitié et comptent ses inversions ; combiner : fusion_compte, qui fusionne et compte les inversions croisées, puis la somme des trois nombres. tri_compte([5, 2, 6, 1, 4, 3]) renvoie ([1, 2, 3, 4, 5, 6], 9).
8. Déroulement de tri_compte([3, 1, 2]) (milieu = 1) :
-
tri_compte([3]): condition d’arrêt, renvoie([3], 0); -
tri_compte([1, 2])(milieu = 1) appelletri_compte([1]), qui renvoie([1], 0), ettri_compte([2]), qui renvoie([2], 0);fusion_compte([1], [2])renvoie([1, 2], 0); l’appel renvoie([1, 2], 0); -
fusion_compte([3], [1, 2]): \(1 < 3\), on place \(1\) et on ajoute \(1 - 0 = 1\) ; \(2 < 3\), on place \(2\) et on ajoute \(1\) ; puis on recopie \(3\). Elle renvoie([1, 2, 3], 2).
L’appel initial renvoie ([1, 2, 3], 0 + 0 + 2), soit ([1, 2, 3], 2) : les inversions sont \((3, 1)\) et \((3, 2)\).
9. Terminaison : le variant est la longueur de la liste. Dans le cas récursif, len(t) >= 2, donc les deux moitiés sont strictement plus courtes que t ; cet entier positif décroît strictement et finit par valoir \(0\) ou \(1\) : la condition d’arrêt. Coût : comme le tri fusion, \(\log_2 n\) niveaux d’appels, et à chaque niveau des fusions de coût total de l’ordre de \(n\) : coût de l’ordre de \(n \log_2 n\). Pour \(n = 10^6\) : environ \(10^6 \times 20 = 2\times 10^7\) opérations, contre \(5\times 10^{11}\) pour la méthode directe, soit environ \(25\,000\) fois moins.
Critiquer une réponse d’IA#
★★ Exercice 11 — Une recherche dichotomique écrite par un assistant d’IA #
Un élève demande à un assistant d’IA : « Écris une fonction récursive Python de recherche dichotomique qui renvoie True si cible est dans le tableau trié tab, entre les indices debut et fin inclus. » Voici la réponse obtenue :
def recherche(tab, cible, debut, fin):
    if debut > fin:                     # intervalle vide : absent
        return False
    milieu = (debut + fin) // 2
    if tab[milieu] == cible:
        return True
    elif cible < tab[milieu]:
        return recherche(tab, cible, debut, milieu)      # moitie gauche
    else:
        return recherche(tab, cible, milieu + 1, fin)    # moitie droite
« À chaque appel, on compare la cible à l’élément du milieu et on ne garde que la moitié utile : l’intervalle est divisé par deux, d’où un coût en \(\log_2 n\). »
-
La réponse est-elle correcte ? ▶ Dérouler à la main
recherche([3, 8, 12, 19, 25], 12, 0, 4), puisrecherche([3, 8, 12, 19, 25], 5, 0, 4)(noter à chaque appel les valeurs dedebut,finetmilieu). -
Localiser et corriger l’erreur.
Coup de pouce
Suivre
debut,finetmilieulors de la recherche de5: que se passe-t-il quanddebut == finet que la cible est plus petite quetab[milieu]? -
Quelle vérification simple, faite avant de faire confiance à la réponse, aurait suffi à détecter l’erreur ?
Corrigé
1. Pour 12 : (0, 4), milieu = 2, tab[2] = 12 \(\to\) True dès le premier appel. Pour 5 : (0, 4) milieu \(2\) (\(12\), on va à gauche) \(\to\) (0, 2) milieu \(1\) (\(8\), à gauche) \(\to\) (0, 1) milieu \(0\) (\(3\), à droite) \(\to\) (1, 1) milieu \(1\) (\(8\), à gauche) \(\to\) (1, 1) milieu \(1\)… L’appel recherche(tab, 5, 1, 1) se rappelle lui-même indéfiniment ; en console : RecursionError: maximum recursion depth exceeded. La réponse est donc fausse : toute valeur absente plus petite que le dernier élément provoque cette boucle sans fin (seule une valeur absente plus grande que tous les éléments, qui part toujours à droite, donne bien False). Les valeurs présentes, elles, sont toujours trouvées.
2. Dans la branche « moitié gauche », l’appel garde milieu dans l’intervalle alors qu’on vient de le tester : l’intervalle (1, 1) ne rétrécit plus (le variant fin - debut ne décroît pas). Ligne corrigée :
return recherche(tab, cible, debut, milieu - 1) # moitie gauche
Avec cette version, recherche(tab, 5, 0, 4) renvoie False et recherche(tab, 12, 0, 4) renvoie toujours True.
3. Tester la fonction sur une valeur absente (pas seulement sur une valeur présente, qui réussit souvent « par chance ») : une valeur absente force la descente jusqu’à l’intervalle vide et révèle immédiatement les erreurs de bornes. Réflexe du cours : fin = milieu - 1 ou debut = milieu + 1, jamais milieu seul.
S’entraîner à l’oral#
★★ Exercice 12 — Expliquer en deux minutes #
Au Grand Oral comme devant l’examinateur de l’épreuve pratique, il faut savoir expliquer une notion clairement, sans lire ses notes. Choisir l’un des sujets suivants (ou le tirer au sort) :
-
Expliquer les trois étapes de la méthode « diviser pour régner » sur l’exemple du tri fusion.
-
Expliquer à un parent pourquoi le tri fusion est bien plus rapide que le tri par insertion sur un million de valeurs.
-
Expliquer pourquoi la recherche dichotomique est un « diviser pour régner » et pourquoi elle exige un tableau trié.
Préparation (5 min, seul). Noter au brouillon trois idées et un exemple, rien de plus : comme au Grand Oral, ces notes servent d’aide-mémoire. Exposé (2 min, chronométré). Debout, face à un camarade, sans lire ses notes et sans rien écrire : tout passe par la parole. Retour (2 min). Le camarade pose une question de relance (on peut alors s’aider d’un schéma), remplit la grille ci-dessous et donne un conseil ; puis on échange les rôles. Cette grille reprend les critères d’évaluation du Grand Oral.
Coup de pouce
Structurer chaque explication en trois temps : une définition en une phrase, un exemple petit et concret déroulé à voix haute, puis le piège (l’erreur que l’auditeur risque de faire). Finir par une phrase qui répond à la question posée. Sujet 2 : comparer deux nombres frappants plutôt que deux formules ; combien de fois peut-on couper un million en deux avant d’arriver à \(1\) ?
| Grille entre camarades | Oui | En partie | Pas encore |
|---|---|---|---|
| Clair — audible, posé ; chaque mot technique est expliqué | ▫ | ▫ | ▫ |
| Juste — c’est exact, et l’exemple montre vraiment l’idée | ▫ | ▫ | ▫ |
| Construit — un fil conducteur, tenu en deux minutes, sans lire | ▫ | ▫ | ▫ |
| Un conseil pour la prochaine fois : | |||
Corrigé
Pas de texte à apprendre par cœur : voici les éléments attendus pour chaque sujet. L’ordre, les mots et l’exemple peuvent être différents ; l’explication est réussie si ces idées y sont, justes et reliées entre elles.
Sujet 1.
-
Diviser : couper le problème en sous-problèmes de même nature, plus petits ; régner : les résoudre récursivement (condition d’arrêt : une liste de \(0\) ou \(1\) élément est triée) ; combiner : fusionner les solutions.
-
Exemple : \([5, 2, 4, 1]\) \(\to\) \([5, 2]\) et \([4, 1]\) \(\to\) \([2, 5]\) et \([1, 4]\) \(\to\) fusion \([1, 2, 4, 5]\).
-
La fusion de deux listes triées compare leurs premiers éléments et prend le plus petit : son coût est proportionnel à la longueur totale.
-
Piège : oublier l’étape « combiner », où se trouve souvent l’essentiel du travail.
Sujet 2.
-
Tri par insertion : dans le pire cas, de l’ordre de \(n^2\) comparaisons (coût quadratique).
-
Tri fusion : environ \(\log_2 n\) niveaux de découpage, chacun coûte de l’ordre de \(n\) : coût en \(n \log_2 n\).
-
En chiffres, pour \(n = 10^6\) : \(n^2 = 10^{12}\) contre \(n \log_2 n \approx 2 \times 10^7\), soit environ \(50\,000\) fois moins d’opérations.
-
Piège : sur une petite liste, ou une liste presque triée, l’insertion reste rapide ; l’écart se voit quand \(n\) devient grand.
Sujet 3.
-
On compare à l’élément du milieu et on ne garde qu’une moitié : un seul sous-problème, et rien à combiner.
-
Exemple : chercher \(11\) dans \([1, 3, 5, 7, 9, 11, 13]\) : milieu \(7 < 11\), on garde \([9, 11, 13]\), milieu \(11\) : trouvé en \(2\) étapes.
-
Coût : environ \(\log_2 n\) étapes (une vingtaine pour un million de valeurs), contre \(n\) pour une recherche séquentielle.
-
Le tri est indispensable : sans lui, rien ne permet d’éliminer une moitié ; piège des bornes (
milieu - 1,milieu + 1) pour que la boucle termine.
Entraînement#
Des séries courtes pour rendre une méthode automatique : même consigne, données différentes. Les réponses sont brèves dans le corrigé.
★ Exercice 13 — Arbres d’appels du tri fusion en série #
• essentiel
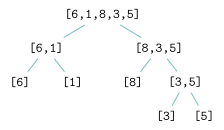
Pour chacune des listes ci-dessous, dessiner l’arbre des appels de tri_fusion (coupe à milieu = len(tab) // 2, jusqu’aux listes d’un élément), compter les appels (appel initial compris), puis donner, dans l’ordre de la remontée, chaque fusion effectuée et la liste obtenue.
Coup de pouce
Même méthode qu’à l’exercice 3 : chaque liste d’au moins deux éléments est coupée en tab[:milieu] et tab[milieu:] (pour une longueur impaire, la moitié gauche est la plus courte). Pour la remontée, chaque nœud reçoit la fusion des deux listes triées de ses fils, en commençant par le bas de l’arbre.
-
[7, 2, 9, 4] -
[6, 1, 8, 3, 5] -
[4, 10, 2, 7, 1, 9, 3]
Corrigé
a) et b) :
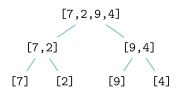
a) \(7\) appels. Remontée : [7] & [2] \(\rightarrow\) [2,7] ; [9] & [4] \(\rightarrow\) [4,9] ; [2,7] & [4,9] \(\rightarrow\) [2,4,7,9].
b) \(9\) appels. Remontée : [6] & [1] \(\rightarrow\) [1,6] ; [3] & [5] \(\rightarrow\) [3,5] ; [8] & [3,5] \(\rightarrow\) [3,5,8] ; [1,6] & [3,5,8] \(\rightarrow\) [1,3,5,6,8].
c)
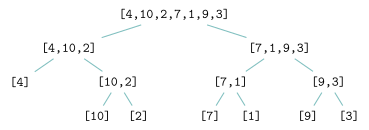
\(13\) appels. Remontée : [10] & [2] \(\rightarrow\) [2,10] ; [4] & [2,10] \(\rightarrow\) [2,4,10] ; [7] & [1] \(\rightarrow\) [1,7] ; [9] & [3] \(\rightarrow\) [3,9] ; [1,7] & [3,9] \(\rightarrow\) [1,3,7,9] ; enfin [2,4,10] & [1,3,7,9] \(\rightarrow\) [1,2,3,4,7,9,10]. (Pour une liste de \(n\) éléments, on trouve toujours \(2n - 1\) appels : \(n\) feuilles et \(n - 1\) fusions.)
★ Exercice 14 — Fusions à la main en série #
• essentiel
Fusionner à la main chacun des couples de listes triées ci-dessous : à chaque étape, noter les deux éléments comparés et celui qui est recopié. Donner la liste obtenue et le nombre de comparaisons.
Coup de pouce
Garder un doigt sur la tête de chaque liste : comparer les deux têtes, recopier la plus petite et avancer dans sa liste. Quand une liste est épuisée, que reste-t-il à faire, et faut-il encore comparer ?
-
[2, 5, 8]et[1, 6, 7] -
[1, 2, 3]et[4, 5] -
[3, 9]et[1, 4, 10, 11]
Corrigé
a) 2 contre 1 \(\to\) 1 ; 2 contre 6 \(\to\) 2 ; 5 contre 6 \(\to\) 5 ; 8 contre 6 \(\to\) 6 ; 8 contre 7 \(\to\) 7 ; la seconde liste est épuisée, on recopie 8. Résultat [1, 2, 5, 6, 7, 8], 5 comparaisons.
b) 1 contre 4 \(\to\) 1 ; 2 contre 4 \(\to\) 2 ; 3 contre 4 \(\to\) 3 ; la première liste est épuisée, on recopie [4, 5]. Résultat [1, 2, 3, 4, 5], 3 comparaisons.
c) 3 contre 1 \(\to\) 1 ; 3 contre 4 \(\to\) 3 ; 9 contre 4 \(\to\) 4 ; 9 contre 10 \(\to\) 9 ; la première liste est épuisée, on recopie [10, 11]. Résultat [1, 3, 4, 9, 10, 11], 4 comparaisons.
▷ Erreur fréquente. En b), continuer à comparer 4 et 5 à une liste vide : dès qu’une liste est épuisée, on recopie le reste de l’autre, déjà trié, sans aucune comparaison.