Cours#
Les données structurées et leur traitement
| Programme | Donnée et donnée personnelle ; métadonnées ; principaux formats et représentations (formats ouverts, CSV) ; table de données (descripteur, enregistrement) ; opérations de recherche, filtre et tri sur une ou plusieurs tables ; données ouvertes (open data) et dans le nuage. |
| Idée | Le monde est noyé sous les données. Bien rangées dans une table (lignes et colonnes), elles deviennent une mine que l’on peut fouiller : chercher, filtrer, trier, croiser. Ce chapitre vous transforme en data-détective. |
| Objectifs | Distinguer donnée, donnée personnelle et métadonnée ; lire une table (descripteur, enregistrement) ; comprendre le format CSV ; rechercher, filtrer, trier et croiser des tables ; utiliser un site d’open data ; mesurer les enjeux (vie privée, nuage, big data). |
Situation de départ
-
Sur un site de vente, vous cochez « moins de 30 € » et « taille M », puis « prix croissant ». Que fait le site, au juste, de la liste de ses articles ?
-
Vos photos sont « dans le nuage ». Où sont-elles vraiment, et qui peut les voir ?
-
Une application vous demande votre âge, votre position et vos contacts. A-t-elle le droit de tout garder et d’en faire ce qu’elle veut ?
Pour les curieux (facultatif) — Un peu d’histoire
Ranger des données par machine est plus vieux que l’ordinateur ! En 1890, les États-Unis doivent recenser près de 63 millions d’habitants ; le recensement précédent, celui de 1880, avait demandé sept ans de dépouillement à la main. L’ingénieur Herman Hollerith invente une machine qui lit des cartes perforées — une carte par personne, un trou par caractéristique : c’est déjà « une fiche par individu, les mêmes rubriques pour tous », l’idée même d’une table. Le recensement de 1890 est bouclé avec plusieurs mois d’avance (U.S. Census Bureau). La société de Hollerith deviendra, par fusions, une certaine… IBM.
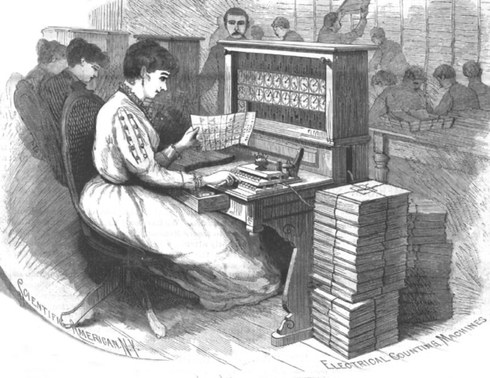
Les machines de Hollerith en 1890
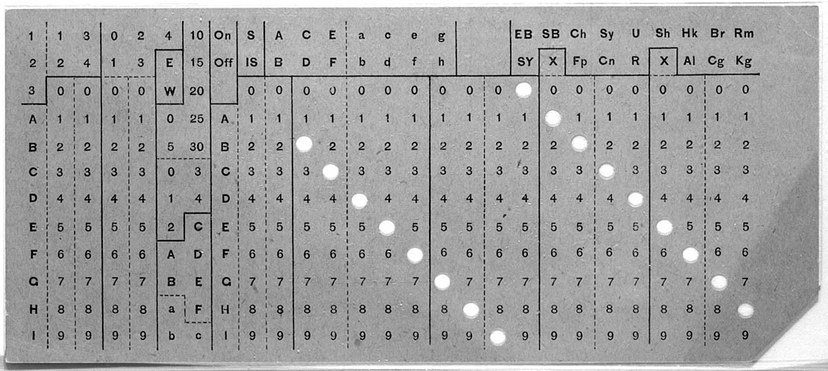
Une carte perforée : une carte par personne
Source : U.S. Census Bureau, pages d’histoire « Herman Hollerith » et « Tabulation and Processing » (recensements de 1880 et 1890), census.gov.
Une donnée, c’est quoi au juste ?#
Un texto, une note, une température, un « j’aime », une position GPS… tout cela, ce sont des données.
Définition 1
Une donnée est une information élémentaire enregistrée (un nombre, un mot, une date, une image…), que l’on peut stocker et traiter par une machine.
Certaines données sont banales ; d’autres vous concernent directement et méritent une protection particulière.
Définition 2
Une donnée personnelle est une information qui permet d’identifier une personne, directement (nom, photo, numéro de téléphone) ou indirectement (adresse IP, position, identifiant, plaque d’immatriculation…).
Exemple(s)
« La température était de 21 °C » est une donnée, mais pas personnelle. « Léa, née le 3 mai 2009 à Monaco » contient des données personnelles.
Les métadonnées : les données sur les données#
Définition 3
Une métadonnée est une donnée qui décrit une autre donnée. Elle ne fait pas partie du contenu, mais l’accompagne : pour une photo, sa date, l’appareil utilisé, le lieu (GPS) ; pour un fichier, son nom, sa taille, sa date de modification.
Méthode — Retrouver les métadonnées d’un fichier
On peut retrouver les métadonnées d’un fichier personnel : un clic droit » « Propriétés » (ou « Informations ») révèle taille, dates, format… Une photo prise au smartphone embarque même, souvent, les coordonnées GPS du lieu de la prise de vue (chapitre Photographie numérique) : une métadonnée qui peut, sans qu’on y pense, trahir où l’on habite.
Activité — Chasse aux métadonnées
Sur un fichier de votre espace personnel (une photo, un document), afficher les propriétés et relever trois métadonnées : la taille, la date de dernière modification, et le format (l’extension). Lesquelles sont des données personnelles ?
▶ Exercices d'application : exercices 1 et 2 (donnée personnelle ? donnée ou métadonnée ?)
Ranger l’information : la table de données#
Pour exploiter des données, on les range dans un tableau à deux dimensions : une table. Voici notre fil rouge, une petite table de jeux vidéo (les ventes sont en millions d’exemplaires, arrondies, d’après les chiffres publiés par les éditeurs en 2023 ; elles ont augmenté depuis) :
| id | titre | studio | annee | genre | pegi | ventes |
|---|---|---|---|---|---|---|
| 1 | Minecraft | 2 | 2011 | bac à sable | 7 | 300 |
| 2 | GTA V | 3 | 2013 | action | 18 | 190 |
| 3 | Wii Sports | 1 | 2006 | sport | 7 | 83 |
| 4 | Mario Kart 8 | 1 | 2014 | course | 3 | 60 |
| 5 | Red Dead Redemption 2 | 3 | 2018 | action | 18 | 55 |
| 6 | Animal Crossing | 1 | 2020 | simulation | 3 | 45 |
Source : chiffres de ventes arrondis (2023), communiqués des éditeurs (Microsoft/Mojang, Take-Two/Rockstar Games, Nintendo).
Définition 4
Dans une table de données :
-
chaque colonne est un descripteur (ou attribut) : ce qu’on renseigne pour chacun (ici
titre,annee,genre…) ; -
chaque ligne est un enregistrement (une fiche, un individu) : elle donne une valeur pour chaque descripteur.
Ainsi, la table ci-dessus a 7 descripteurs et 6 enregistrements. La ligne d’id 1 est un enregistrement ; sa valeur pour le descripteur genre est bac à sable.
À retenir — Pourquoi un descripteur « id » ?
Deux jeux pourraient porter le même titre, ou sortir la même année. Pour distinguer sans ambiguïté chaque enregistrement, on ajoute souvent un descripteur id : un numéro unique. On dit que c’est un identifiant.
Activité — Lire une table
À l’aide de la table jeu :
-
Combien y a-t-il de descripteurs ? d’enregistrements ?
-
Quelle est la valeur du descripteur
ventespour Mario Kart 8 ? -
Citer un descripteur dont les valeurs sont des nombres, et un dont les valeurs sont du texte.
▶ Exercices d'application : exercices 3 et 4 (vocabulaire de la table ; concevoir une table)
Le format CSV : du texte, et rien que du texte#
Comment stocker une table dans un fichier que tous les logiciels sauront lire ? Avec le format CSV.
Définition 5
Un fichier CSV (Comma-Separated Values, « valeurs séparées par des virgules ») est un simple fichier texte qui représente une table :
-
la première ligne donne les descripteurs (l’en-tête) ;
-
chaque ligne suivante est un enregistrement ;
-
sur une ligne, les valeurs sont séparées par un séparateur (souvent la virgule
,ou le point-virgule;).
Les trois premières lignes de notre table, en CSV :
id,titre,studio,annee,genre,pegi,ventes
1,Minecraft,2,2011,bac a sable,7,300
2,GTA V,3,2013,action,18,190
Règle 1 — Format ouvert / format fermé
Le CSV est un format ouvert : sa structure est publique, n’importe quel logiciel (tableur, éditeur de texte, navigateur, programme) peut le lire, aujourd’hui comme dans trente ans, sans dépendre d’une marque. À l’inverse, un format fermé (propriétaire) est contrôlé par un éditeur, qui seul en connaît tous les détails : l’ancien format .xls d’Excel, par exemple. Son successeur, le .xlsx, est aujourd’hui une norme publiée, mais il reste bien plus complexe qu’un simple fichier texte. Les données ouvertes (open data) sont presque toujours publiées en formats ouverts.
Quand un mauvais format fait « perdre » 16 000 malades
En octobre 2020, l’agence de santé publique anglaise a « perdu » 15 841 résultats de tests COVID-19. La cause ? Les laboratoires envoyaient leurs résultats en fichiers CSV ; pour les rassembler, l’agence les importait automatiquement dans un vieux format de tableur, le .xls, limité à 65 536 lignes. Chaque cas occupant plusieurs lignes, un fichier ne pouvait contenir qu’environ 1 400 cas. Une fois cette limite atteinte, les cas suivants n’étaient signalés par aucune erreur… ils étaient silencieusement ignorés. Résultat : près de 48 000 personnes ayant croisé un cas positif n’ont pas été prévenues à temps (Public Health England et BBC News, octobre 2020). Le fichier CSV d’origine, lui, n’avait pas de plafond : un texte peut avoir autant de lignes qu’on veut. La morale : le bon format de données peut avoir des conséquences très réelles.
Sources : Public Health England, communiqué du 5 octobre 2020 (15 841 cas non signalés) ; BBC News, « Excel: Why using Microsoft’s tool caused Covid-19 results to be lost », 5 octobre 2020.
À retenir — L’open data : les données publiques, à tous
Depuis 2011, l’État français ouvre ses données sur data.gouv.fr (portail géré par Etalab, le service de l’État chargé d’ouvrir les données publiques) ; la Principauté de Monaco fait de même sur son portail open data. Horaires de bus, qualité de l’air, résultats d’élections, prénoms donnés chaque année… des milliers de tables sont librement téléchargeables, le plus souvent en CSV. Fouiller ces données est devenu un vrai pouvoir citoyen — et le métier des data-journalistes.
Source : Etalab, data.gouv.fr, page « À propos » (ouverture du portail en 2011).
▶ Exercices d'application : exercices 5 à 7 (lire et écrire du CSV)
Fouiller une table : rechercher, filtrer, trier#
C’est le cœur du chapitre — et du métier de data-détective. Trois opérations reviennent sans cesse.
Règle 2 — Les trois opérations de base
-
Rechercher : trouver l’enregistrement (ou les) qui correspond à une valeur précise.
« Quel est le genre de Minecraft ? » -
Filtrer : ne garder que les enregistrements qui vérifient un critère.
« Tous les jeux de genreaction. » \(\rightarrow\) GTA V, Red Dead Redemption 2. -
Trier : ranger les enregistrements selon les valeurs d’un descripteur, en ordre croissant ou décroissant.
« Les jeux du plus vendu au moins vendu. » \(\rightarrow\) Minecraft, GTA V, Wii Sports…
Exemple(s) — Filtrer puis trier
« Les jeux tout public (pegi \(\leqslant\) 7), du plus récent au plus ancien. » On filtre d’abord (pegi vaut 3 ou 7) : Minecraft, Wii Sports, Mario Kart 8, Animal Crossing. Puis on trie par annee décroissante : Animal Crossing (2020), Mario Kart 8 (2014), Minecraft (2011), Wii Sports (2006).
À retenir — Un critère peut en combiner plusieurs
On combine des conditions avec ET (les deux à la fois) ou OU (au moins une). « Les jeux action ET sortis après 2015 » ne garde que Red Dead Redemption 2. C’est le rôle de and et de or en Python (chapitre Les bases de Python).
Croiser deux tables#
Notre table range le studio sous forme d’un numéro (2, 3…), pas d’un nom. Les noms sont dans une seconde table, studio :
| id | nom | pays |
|---|---|---|
| 1 | Nintendo | Japon |
| 2 | Mojang | Suède |
| 3 | Rockstar Games | États-Unis |
Règle 3 — Croiser (ou fusionner) deux tables
Deux tables partagent souvent un descripteur commun (ici, le numéro de studio). Croiser les tables, c’est compléter chaque enregistrement de l’une par les informations de l’autre qui a la même valeur pour ce descripteur.
Exemple(s)
Minecraft a studio = 2 ; dans la table studio, l’id 2 est Mojang (Suède). En croisant les deux tables, on apprend donc que Minecraft est édité par Mojang, un studio suédois — une information qu’aucune des deux tables ne donnait à elle seule.
Activité — Data-détective : premières fouilles
Sur les tables jeu et studio :
-
Rechercher : en quelle année est sorti Red Dead Redemption 2 ?
-
Filtrer : donner les titres des jeux déconseillés aux mineurs (
pegi= 18). -
Trier : ranger tous les jeux par
anneecroissante. -
Croiser : dans quel pays est édité Mario Kart 8 ?
▶ Exercices d'application : exercices 8 à 13 (rechercher, filtrer, trier, calculer, croiser)
L’outil du quotidien : le tableur#
Pour réaliser ces opérations sans programmer, l’outil roi est le tableur (Excel, LibreOffice Calc, Google Sheets…). On y ouvre un CSV, et chaque descripteur devient une colonne (A, B, C…), chaque enregistrement une ligne numérotée.
Règle 4 — Ce que le tableur sait faire d’un clic
-
Trier une colonne (croissant / décroissant) : bouton Trier.
-
Filtrer : le filtre automatique n’affiche que les lignes qui vérifient un critère.
-
Calculer sur une colonne avec des formules :
=SOMME(...),=MOYENNE(...),=MAX(...)… -
Représenter les données par un graphique (barres, camembert…).
Remarque
Le tableur reste le logiciel le plus utilisé au monde pour manipuler des données. Les TP tableur proposés en fin de chapitre en font pratiquer les gestes de base (formules, recopie, calculs sur une colonne) ; les mêmes gestes servent ensuite à trier et filtrer une vraie table, par exemple jeux.csv ouvert dans le tableur (menu Données : Trier, Filtre automatique). (Attention toutefois au piège du § III : un tableur a des limites cachées que le CSV n’a pas.)
▶ Exercices d'application : exercices 14 et 15 (fouiller au tableur ; lire des formules)
Données personnelles, nuage et big data#
Vos données valent de l’or : le RGPD#
Chaque site, chaque application collecte des données sur vous. La loi encadre cette collecte.
Règle 5 — Le RGPD
Le RGPD (Règlement Général sur la Protection des Données, 2018) protège vos données personnelles dans l’Union européenne. Il impose notamment : le consentement (on doit vous demander votre accord), un but précis (on ne collecte que le nécessaire), et des droits pour vous : accéder à vos données, les corriger, et les faire effacer (« droit à l’oubli »).
Vos droits. Si vous résidez en France (ou dans l’Union européenne), vos droits relèvent du RGPD et de la loi Informatique et libertés ; l’autorité de contrôle est la CNIL. En France, en dessous de 15 ans, l’inscription à un service en ligne demande l’accord des parents.
Et à Monaco ?
Monaco n’est pas membre de l’Union européenne : la loi n° 1.565 (2024) y garantit les mêmes grands droits, sous le contrôle de l’APDP (voir l’encadré « Et à Monaco ? » du chapitre Les réseaux sociaux).
Les données dans le nuage (cloud)#
Définition 6
Stocker ses données dans le nuage (cloud), c’est les enregistrer non pas sur son appareil, mais sur des serveurs distants, accessibles par Internet (photos synchronisées, documents partagés, sauvegardes…).
À retenir — Le nuage : pratique… mais
Le nuage offre l’accès partout et le partage facile. En contrepartie : vos données sont chez quelqu’un d’autre (une entreprise, souvent à l’étranger), il faut une connexion, et la question se pose : qui peut les lire, et où sont-elles vraiment stockées ?
Le big data : le déluge de données#
Règle 6 — Les « 3 V » du big data
On parle de big data (mégadonnées) quand les données deviennent trop volumineuses pour les outils classiques. On les caractérise par trois V : le Volume (des quantités colossales), la Vélocité (elles arrivent en continu, très vite) et la Variété (textes, images, capteurs, clics…). Bien exploitées, elles nourrissent les recommandations, les prévisions, l’intelligence artificielle.
Activité — Explorer un vrai jeu de données ouvert
Sur data.gouv.fr (ou le portail open data de Monaco) :
-
Chercher un jeu de données qui vous intéresse (transports, environnement, culture…) et noter son titre et son format (CSV ?).
-
Combien a-t-il de descripteurs (colonnes) ? Citez-en trois.
-
Formuler une question à laquelle ces données permettraient de répondre par un tri ou un filtre.
▶ Exercices d'application : exercices 16 et 17 (open data ; mes données, mes droits), défi 18 (data-détective sur l’open data), exercice 19 (critiquer une réponse d’IA), exercice 20 (Python au service du thème)
Pour les curieux (facultatif) — Liens avec d’autres chapitres
-
Déjà vu : les métadonnées EXIF d’une photo (chapitre Photographie numérique) forment une petite fiche de descripteurs ; un critère combiné s’écrit avec
andetoren Python (chapitre Les bases de la programmation Python). -
À venir : au chapitre Localisation, cartographie et mobilité, une trame NMEA se lira comme une ligne de CSV ; au dernier chapitre, les mesures des capteurs d’objets connectés viendront grossir le nuage et le big data.
-
Plus loin : en spécialité NSI de Première, on lit des fichiers CSV en Python et on filtre une table avec une boucle
foret un testif.
Bilan — la carte mémoire#
Les mots importants du thème sont définis dans le lexique.
| Notion | À retenir |
|---|---|
| Donnée | une information élémentaire enregistrée (nombre, mot, date…). |
| Donnée personnelle | permet d’identifier une personne (directement ou non). |
| Métadonnée | une donnée qui décrit une autre donnée (date, taille, GPS d’une photo…). |
| Table | lignes et colonnes ; descripteur = colonne, enregistrement = ligne. |
| CSV | fichier texte, format ouvert ; 1re ligne = en-tête ; séparateur , ou ;. |
| Format ouvert / fermé | public et pérenne (CSV) / contrôlé par un éditeur (ancien .xls). |
| Rechercher / filtrer / trier | trouver / ne garder que…/ ranger selon un descripteur. |
| Croiser deux tables | les relier par un descripteur commun. |
| Tableur | l’outil pour trier, filtrer, calculer, représenter (Excel, Calc, Sheets). |
| Open data | données publiques librement réutilisables (data.gouv.fr…). |
| RGPD | protège les données personnelles (UE) : consentement, droits, droit à l’oubli (CNIL). |
| Monaco | loi n° 1.565 (2024) : les mêmes grands droits ; autorité : APDP. |
| Nuage (cloud) | données sur des serveurs distants, accessibles par Internet. |
| Big data | les « 3 V » : Volume, Vélocité, Variété. |
Retour à la situation de départ
-
Ses articles sont rangés dans une table : une ligne par article (un enregistrement), une colonne par caractéristique (un descripteur) (§ II). Le site filtre avec un critère combiné par ET (prix et taille), puis trie selon le descripteur prix (§ IV).
-
Sur des serveurs distants, accessibles par Internet, chez une entreprise souvent à l’étranger (§ VI) : c’est pratique, mais il faut une connexion, et il faut se demander qui peut les lire.
-
Non : ce sont des données personnelles (§ I). Le RGPD (UE) et la loi n° 1.565 (Monaco) imposent votre consentement et un but précis, et vous donnent le droit d’accéder à vos données, de les corriger et de les faire effacer (§ VI).
Débat argumenté
Un débat, proposé en fin de chapitre, accompagne ce thème : « Faut-il ouvrir à tous le plus possible de données publiques, même quand elles concernent des personnes ? » (documents, rôles, tableau d’arguments et trace écrite, environ 50 min).
Savoir-faire à maîtriser#
À la fin du chapitre, je sais…
Savoir-faire : je me positionne
-
distinguer une donnée, un descripteur (attribut) et un enregistrement (ligne) ;
-
retrouver les métadonnées d’un fichier personnel et les distinguer des données ;
-
lire une table de données : repérer les descripteurs et compter les enregistrements ;
-
reconnaître le format CSV (du texte, un séparateur, une ligne d’en-tête) et l’ouvrir dans un tableur ;
-
utiliser un site de données ouvertes (open data) pour sélectionner et récupérer des données ;
-
rechercher, filtrer et trier des enregistrements selon un ou plusieurs critères ;
-
réaliser un tri croissant ou décroissant sur une colonne ;
-
citer les enjeux liés aux données personnelles, au cloud et au big data (les 3 V).