Cours#
Graphes
| Programme (BO) | « Graphes : structures relationnelles. Sommets, arcs, arêtes, graphe orienté ou non orienté. Modéliser des situations sous forme de graphes. Écrire les implémentations correspondantes d’un graphe : matrice d’adjacence, liste de successeurs / de prédécesseurs. Passer d’une représentation à une autre. Parcourir un graphe en largeur, en profondeur. Repérer la présence d’un cycle. Chercher un chemin dans un graphe. » |
| Prérequis | les piles et les files (indispensables pour les parcours !), les dictionnaires et les listes de listes, la récursivité, les classes, la notion de coût d’un algorithme. Les arbres (un arbre est un graphe particulier). (→ fiches de révision : ch. 1, ch. 2, ch. 3, ch. 5) |
| Objectifs | reconnaître une situation qui appelle un graphe et la modéliser ; maîtriser le vocabulaire ; implémenter un graphe de trois façons et passer de l’une à l’autre ; parcourir un graphe en largeur (file) et en profondeur (pile) ; trouver un chemin, le plus court chemin, détecter un cycle. |
Situation de départ
-
Comment ranger dans un programme un plan de métro, un réseau d’amis ou le Web, où n’importe quel élément peut être relié à n’importe quel autre ?
-
Comment une application de transport trouve-t-elle le trajet qui passe par le moins de stations, sans essayer tous les chemins possibles ?
-
Comment explorer un labyrinthe ou un réseau sans tourner en rond indéfiniment ?
Pourquoi un graphe ? Parce que le monde est un réseau#
Regardez autour de vous. Le plan du métro : des stations, reliées par des lignes. Vos amitiés : des personnes, reliées par des « amis ». Le Web : des milliards de pages, reliées par des liens. Un GPS : des carrefours, reliés par des routes. Internet : des routeurs, reliés par des câbles. Le cerveau : des neurones, reliés par des synapses. Une molécule : des atomes, reliés par des liaisons.
À chaque fois, la même idée revient : des objets, et des relations entre ces objets. C’est exactement cela, un graphe. Aucune autre structure de ce cours ne capture aussi bien cette réalité : une liste range « en ligne », un arbre range « en hiérarchie », mais seul le graphe autorise n’importe quelle relation entre n’importe quels objets — des boucles, des raccourcis, des allers-retours. C’est la structure la plus générale, et sans doute la plus utile de toute l’informatique.
Règle 1 — La grande idée
Un graphe modélise un ensemble d’objets (les sommets) et les relations qui les lient deux à deux (les arêtes). Dès qu’un problème parle de « qui est relié à qui », il parle de graphes.
L’acte de naissance : les sept ponts de Königsberg (1736)#
Pour les curieux (facultatif) — Un peu d’histoire
Au xviiie siècle, la ville de Königsberg est traversée par une rivière formant deux îles, reliées aux berges et entre elles par sept ponts. Les habitants se demandaient si l’on pouvait se promener en traversant chaque pont une fois et une seule. En 1736, Leonhard Euler règle la question en oubliant la carte : peu importe la forme des îles ou la longueur des ponts, seul compte ce qui est relié à quoi. Il remplace la ville par quatre points (les berges N et S, les îles O et E) et sept traits (les ponts) : c’est le premier graphe de l’histoire, et l’acte de naissance de la théorie des graphes. En comptant les ponts qui partent de chaque terre, il prouve que la promenade est impossible (voir le théorème d’Euler, à la fin de la section II). Euler (1707–1783), Suisse alors membre de l’Académie des sciences de Saint-Pétersbourg, est l’un des mathématiciens les plus féconds de l’histoire : ses œuvres complètes remplissent plus de soixante-dix volumes.
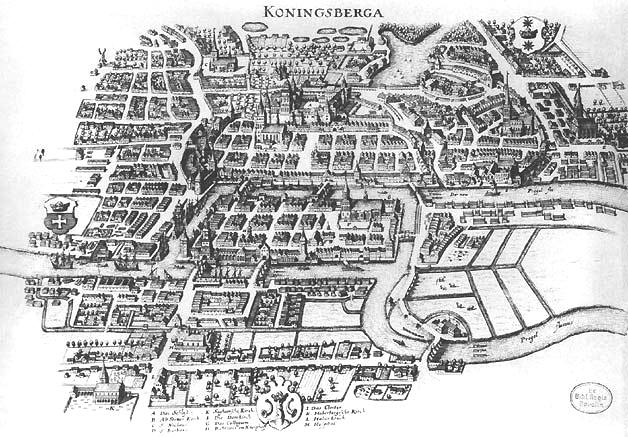
Königsberg et ses ponts (gravure de 1652)
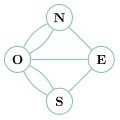
Le graphe d’Euler
Euler (par J. E. Handmann, 1753)
À retenir — la leçon d’Euler : modéliser
Retenez la leçon d’Euler, car c’est toute la démarche de ce chapitre : modéliser, c’est jeter les détails inutiles pour ne garder que la structure des relations. Une fois le bon graphe dessiné, le problème est souvent à moitié résolu.
Des situations où le graphe s’impose#
Exemple — Quatre problèmes, un seul outil
-
Le GPS et le plus court chemin. Carrefours \(=\) sommets, routes \(=\) arêtes (pondérées par les distances ou les temps). Trouver son itinéraire, c’est chercher un chemin de coût minimal dans un graphe.
-
Les réseaux sociaux. Personnes \(=\) sommets, relations \(=\) arêtes. « Combien d’intermédiaires entre deux inconnus ? », « qui suggérer comme ami ? », « qui est la personne la plus centrale ? » : autant de questions de graphes.
-
Le Web et Google. Pages \(=\) sommets, liens hypertextes \(=\) arcs (orientés !). Le classement des résultats de Google repose sur un parcours de cet immense graphe.
-
La planification de tâches. Étapes d’une recette, d’un chantier, d’un programme \(=\) sommets ; « il faut faire ceci avant cela » \(=\) arcs. On ordonne le travail en parcourant le graphe des dépendances.
Nous n’étudierons qu’une petite partie de cette théorie immense : comment représenter un graphe en Python, et comment le parcourir pour répondre à des questions concrètes.
Le vocabulaire des graphes#
Un graphe est un ensemble de sommets (vertices ou nodes en anglais) reliés par des arêtes ou des arcs (edges). Il peut être non orienté ou orienté.
Définition 1 — Graphe, ordre, taille
Un graphe \(G=(S,A)\) est la donnée d’un ensemble fini \(S\) de sommets et d’un ensemble \(A\) d’arêtes (des paires de sommets, en non orienté) ou d’arcs (des couples ordonnés, en orienté).
-
l’ordre du graphe est son nombre de sommets, souvent noté \(n = |S|\) ;
-
la taille du graphe est son nombre d’arêtes, souvent noté \(m = |A|\).
Deux sommets reliés par une arête sont dits adjacents (ou voisins).
Graphe non orienté#
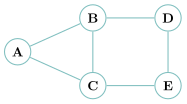
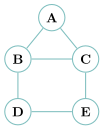
Dans un graphe non orienté, une arête se parcourt dans les deux sens. Une chaîne est une suite de sommets reliés de proche en proche, par exemple A -- C -- E -- D ; sa longueur est le nombre d’arêtes, ici \(3\).
Les sommets B et C sont adjacents à A : ce sont ses voisins. Le degré d’un sommet est son nombre de voisins (\(\deg(\texttt{A})=2\), \(\deg(\texttt{B})=3\)).
↺ Retour sur l'activité. Les points et les traits de l’activité étaient des sommets et des arêtes, et le « nombre de traits en un point » était le degré. Remplacer la carte de Königsberg par quatre points et sept traits, c’était modéliser.
Exemple concret : le graphe des amis sur Facebook est non orienté — si vous êtes ami avec quelqu’un, la réciproque est vraie.
Propriété 1 — Lemme des poignées de main
Dans un graphe non orienté, la somme des degrés de tous les sommets est égale au double du nombre d’arêtes : $\(\sum_{s \in S} \deg(s) = 2\,m.\)$ En conséquence, le nombre de sommets de degré impair est toujours pair.
Démonstration
Chaque arête relie exactement deux sommets ; elle est donc comptée deux fois dans la somme des degrés (une fois à chaque extrémité). La somme des degrés vaut donc \(2m\). Comme \(2m\) est pair, la somme des degrés est paire : les sommets de degré impair doivent se « compenser » deux par deux, donc ils sont en nombre pair.
↺ Retour sur l'activité. Voilà pourquoi le défi de l’activité était impossible : aucune figure ne peut avoir exactement un point « impair », puisque ces points sont toujours en nombre pair.
Pour les curieux (facultatif)
Joli nom : si, dans une soirée, chaque poignée de main relie deux personnes, alors le nombre total de mains serrées (comptées par personne) est pair — et il y a toujours un nombre pair d’invités ayant serré un nombre impair de mains !
Graphe orienté#
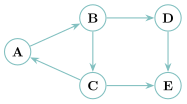
Dans un graphe orienté, un arc ne se parcourt que dans le sens de la flèche. Un chemin est une suite de sommets reliés par des arcs dans le bon sens, par exemple A\(\to\)B\(\to\)D\(\to\)E. Les voisins (ou successeurs) de B sont C et D (mais pas A !).
Exemple concret : le graphe des abonnements sur X (Twitter) ou Instagram est orienté : on peut « suivre » quelqu’un sans être suivi en retour.
Graphe pondéré#
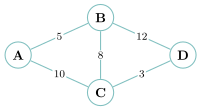
Un graphe est pondéré (ou valué) si chaque arête porte une valeur numérique — son poids (coût, distance, temps, débit…). Exemples : les distances entre villes sur une carte routière, le coût d’une liaison entre routeurs (on le retrouvera au chapitre Réseaux, avec le protocole OSPF).
Connexité, cycle#
Définition 2 — Connexité
Un graphe est connexe s’il est « d’un seul tenant » : n’importe quelle paire de sommets peut être reliée par une chaîne. Sinon, il se décompose en plusieurs composantes connexes (ses « morceaux »).
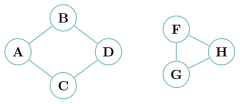
Ce graphe n’est pas connexe : aucune chaîne ne relie A à F. Il a deux composantes connexes : \(\{\)A,B,C,D\(\}\) et \(\{\)F,G,H\(\}\).
Définition 3 — Cycle
Un cycle est une chaîne (non orientée) ou un chemin (orienté) qui revient à son point de départ sans réemprunter deux fois la même arête. Un graphe connexe sans cycle est exactement un… arbre : voilà le lien avec le chapitre Arbres.
Quelques graphes particuliers#
Définition 4 — Sous-graphe, sommet isolé, graphe complet
-
un sous-graphe de \(G\) s’obtient en ne gardant qu’une partie des sommets de \(G\) et une partie des arêtes qui les relient (les composantes connexes en sont des exemples) ;
-
un sommet est isolé si son degré est nul (aucun voisin) ;
-
un graphe est complet si toute paire de sommets est reliée par une arête. Un graphe complet à \(n\) sommets possède alors \(\dfrac{n(n-1)}{2}\) arêtes (chacun des \(n\) sommets est relié aux \(n-1\) autres, et chaque arête est comptée deux fois).
Chaînes eulériennes : le théorème d’Euler au-delà du programme#
Revenons à l’énigme fondatrice des sept ponts de Königsberg (§ I). On peut maintenant l’énoncer proprement.
Définition 5 — Chaîne et cycle eulériens
Une chaîne eulérienne est une chaîne qui emprunte chaque arête du graphe une fois et une seule. Si, de plus, elle revient à son point de départ, c’est un cycle eulérien.
La question de Königsberg était donc : ce graphe admet-il une chaîne eulérienne ? Euler y répond complètement, et sa réponse ne dépend que des degrés des sommets.
Théorème 1 — Euler, 1736 ; Hierholzer, 1873 au-delà du programme
Soit \(G\) un graphe connexe.
-
\(G\) admet un cycle eulérien si et seulement si tous ses sommets sont de degré pair ;
-
\(G\) admet une chaîne eulérienne (sans forcément revenir au départ) si et seulement s’il a exactement zéro ou deux sommets de degré impair (et, s’il y en a deux, ce sont nécessairement le départ et l’arrivée).
Pour les curieux (facultatif) — L’idée
Le sens « facile » est intuitif : chaque fois qu’on traverse un sommet intermédiaire, on « consomme » deux arêtes (une pour entrer, une pour sortir). Un sommet par lequel on ne fait que passer doit donc avoir un degré pair. Seuls le départ et l’arrivée peuvent avoir un degré impair — et ils coïncident dans le cas d’un cycle, qui exige alors tous les degrés pairs. C’est ce sens que démontre Euler en 1736 ; la réciproque (si les degrés conviennent et que le graphe est connexe, la chaîne existe) ne sera démontrée qu’en 1873, par Carl Hierholzer.
Exemple — Königsberg tranché
Dans le graphe des ponts, les quatre terres ont pour degrés \(3,3,3,5\) : quatre sommets de degré impair. Comme il en faudrait au plus deux, aucune chaîne eulérienne n’existe : la promenade rêvée par les habitants est bel et bien impossible. Euler l’a démontré sans essayer un seul trajet — juste en comptant des degrés.
↺ Retour sur l'activité. La règle conjecturée dans l’activité est ce théorème : la maison (deux points impairs, A et B) se trace en partant de A ou de B, l’enveloppe fermée (quatre points impairs) est impossible, et le nœud papillon (aucun point impair) se trace en revenant au départ, d’où que l’on parte.
Pour les curieux (facultatif)
Ce théorème n’est pas au programme : on le donne pour la culture, et parce qu’il montre magnifiquement la puissance de la modélisation par graphes. À ne pas confondre avec le parcours d’un graphe (passer par tous les sommets) : ici on veut passer par toutes les arêtes.
▶ Exercices d'application : exercices 1 à 3 (vocabulaire et modélisation)
Modéliser un graphe en Python#
Pour représenter un graphe, il faut se donner une convention répondant à deux questions : qui sont les sommets ? et pour chaque sommet, quels sont ses voisins ? (et éventuellement le poids de l’arête). Il existe pour cela trois représentations classiques — et savoir passer de l’une à l’autre est une capacité attendue au bac.
Dans toute cette partie, on illustre avec ce petit graphe non orienté, appelé \(G\) :
Représentation par matrice d’adjacence#
Principe. On numérote les sommets (ici par ordre alphabétique : A\(=0\), B\(=1\)…). On construit un tableau carré \(M\) où \(M[i][j]=1\) si les sommets de rangs \(i\) et \(j\) sont voisins, et \(0\) sinon. Ce tableau est la matrice d’adjacence.
À retenir — matrice symétrique ou non
Pour un graphe non orienté, \(M[i][j]=M[j][i]\) : la matrice est symétrique (l’arête B–C donne un \(1\) de part et d’autre de la diagonale). Pour un graphe orienté, elle ne l’est pas forcément. Pour un graphe pondéré, on remplace les \(1\) par les poids.
En Python, une matrice est naturellement une liste de listes :
#      A  B  C  D  E
M = [ [0, 1, 1, 0, 0],   # A
      [1, 0, 1, 1, 0],   # B
      [1, 1, 0, 0, 1],   # C
      [0, 1, 0, 0, 1],   # D
      [0, 0, 1, 1, 0] ]  # E
Propriété 2 — Coût de la matrice d’adjacence
Pour un graphe à \(n\) sommets :
-
mémoire : \(O(n^2)\) (on stocke \(n\times n\) cases, y compris tous les zéros) ;
-
tester si deux sommets sont voisins : \(O(1)\) (un simple accès
M[i][j]) ; -
lister les voisins d’un sommet : \(O(n)\) (il faut parcourir toute sa ligne).
Représentation par liste d’adjacence#
Principe. À chaque sommet, on associe la liste de ses voisins. On utilise un dictionnaire : les clés sont les sommets, les valeurs sont les listes de voisins. (Pour un graphe orienté, on stocke la liste des successeurs, ou celle des prédécesseurs.)
G = {'A': ['B', 'C'],
     'B': ['A', 'C', 'D'],
     'C': ['A', 'B', 'E'],
     'D': ['B', 'E'],
     'E': ['C', 'D']}
Propriété 3 — Coût de la liste d’adjacence
Pour un graphe à \(n\) sommets et \(m\) arêtes :
-
mémoire : \(O(n+m)\) — on ne stocke que les arêtes présentes, pas les zéros. C’est bien plus économique quand le graphe a peu d’arêtes (graphe « creux ») ;
-
accéder à la liste des voisins d’un sommet : \(O(1)\) (accès direct par la clé) ; la parcourir (pour énumérer ces voisins) : \(O(\deg)\), où \(\deg\) est le degré du sommet ;
-
tester si deux sommets sont voisins : \(O(\deg)\) (il faut parcourir la liste des voisins).
Règle 2 — Quelle représentation choisir ?
Matrice : rapide pour tester une arête, mais gourmande en mémoire — idéale si le graphe est dense (beaucoup d’arêtes). Liste : économe en mémoire, rapide pour lister les voisins — idéale si le graphe est creux (peu d’arêtes), ce qui est le cas le plus fréquent (un réseau social : chacun connaît quelques centaines de personnes, pas des millions).
Représentation par liste de listes#
Quand les sommets sont numérotés de \(0\) à \(n-1\), on peut se passer du dictionnaire : la liste d’adjacence devient une simple liste de listes, où la case d’indice \(i\) contient la liste des voisins du sommet \(i\). C’est la convention de plusieurs sujets de bac. Par exemple, le graphe
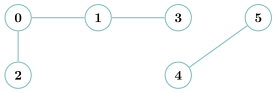
se représente par adj = [[1, 2], [0, 3], [0], [1], [5], [4]] : le sommet \(0\) a pour voisins \(1\) et \(2\), le sommet \(1\) a pour voisins \(0\) et \(3\), etc.
Règle 3 — Passer d’une représentation à l’autre — capacité attendue
On sait convertir chaque représentation en une autre : parcourir la matrice ligne par ligne pour bâtir les listes de voisins ; ou parcourir un dictionnaire d’adjacence pour remplir une matrice de \(0\) et de \(1\). C’est un exercice classique du bac (voir la feuille).
▶ Exercices d'application : exercices 4 à 7 (représenter un graphe)
Une classe Graphe#
Manipuler directement le dictionnaire G fonctionne, mais rien n’empêche alors d’oublier un sens d’une arête et d’obtenir un graphe incohérent. On encapsule donc la représentation dans une classe (chapitre 2) : l’utilisateur ne touche plus au dictionnaire, il passe par quelques méthodes (même démarche que pour les piles et les files). On se limite ici aux graphes non orientés.
class Graphe:
    # graphe non oriente, stocke par listes d'adjacence
    def __init__(self, sommets):
        self.sommets = sommets
        self.adj = {}                 # sommet -> liste de ses voisins
        for s in sommets:
            self.adj[s] = []

    def ajoute_arete(self, a, b):
        self.adj[a].append(b)
        self.adj[b].append(a)         # non oriente : dans les deux sens

    def voisins(self, s):
        return self.adj[s]

    def sont_voisins(self, a, b):
        return b in self.adj[a]
La méthode ajoute_arete est la seule à modifier le graphe, et elle met toujours à jour les deux listes : la symétrie est garantie par construction.
Pour construire le graphe \(G\) de la partie précédente, on part de la liste de ses arêtes :
g = Graphe(['A', 'B', 'C', 'D', 'E'])
aretes = [('A', 'B'), ('A', 'C'), ('B', 'C'), ('B', 'D'), ('C', 'E'), ('D', 'E')]
for (a, b) in aretes:
    g.ajoute_arete(a, b)
>>> g.voisins('B')
['A', 'C', 'D']
>>> g.sont_voisins('D', 'E'), g.sont_voisins('A', 'D')
(True, False)
On retrouve la ligne B de la matrice d’adjacence, et le dictionnaire g.adj est exactement le dictionnaire G écrit plus haut.
Remarque
Pour un graphe orienté, il suffirait de retirer la deuxième ligne de ajoute_arete : on n’ajoute alors b que comme successeur de a.
▶ Exercices d'application : exercice 8 (la classe Graphe)
Parcourir un graphe#
Parcourir un graphe, c’est visiter tous ses sommets de proche en proche, à partir d’un sommet de départ. C’est l’opération fondamentale : trouver un chemin, la sortie d’un labyrinthe, tester la connexité, détecter un cycle… tout repose sur un parcours.
Règle 4 — Attention
Parcourir un graphe n’est pas la même chose que balayer bêtement le dictionnaire ou la matrice ! Un parcours suit les arêtes, de voisin en voisin.
Le schéma commun à tous les parcours#
Tous les parcours suivent le même squelette :
-
on part d’un sommet et on le met dans une structure d’attente
S; -
tant que
Sn’est pas vide : on en retire un sommet (on le « visite »), et on ajoute àSses voisins pas encore rencontrés.
Règle 5 — La différence cruciale avec les arbres
Dans un arbre, on ne peut jamais revenir sur ses pas : les sous-arbres sont disjoints. Dans un graphe, un voisin peut déjà avoir été vu (par un cycle, un raccourci…). Il est donc indispensable de mémoriser les sommets déjà découverts, sinon le parcours tourne en rond indéfiniment.
↺ Retour sur l'activité. Dans l’activité du musée, le premier gardien tournait en rond faute de cocher les salles visitées, et le second restait bloqué faute de liste des salles à visiter : la mémoire des sommets découverts et la structure d’attente S corrigent exactement ces deux défauts.
Et voici la clé de tout le chapitre : le choix de la structure S change la nature du parcours. C’est là que les piles et les files du début d’année reviennent en force.
Règle 6 — File ou pile : les deux parcours
-
Sest une file (FIFO) \(\Rightarrow\) on visite d’abord les sommets les plus proches du départ \(\Rightarrow\) parcours en largeur (BFS, Breadth First Search). -
Sest une pile (LIFO) \(\Rightarrow\) on file « le plus loin possible » avant de revenir en arrière \(\Rightarrow\) parcours en profondeur (DFS, Depth First Search).
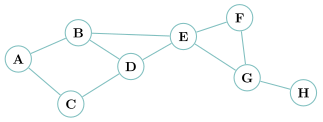
Pour la suite, on utilise ce graphe à 8 sommets (les voisins sont toujours donnés par ordre alphabétique) :
Le parcours en largeur (BFS)#
On explore le graphe « par cercles concentriques » : d’abord le départ, puis tous ses voisins (distance \(1\)), puis les voisins de ceux-ci (distance \(2\)), etc. On tient à jour :
-
une liste
traites: les sommets déjà visités (renvoyée à la fin) ; -
une liste
decouverts: tous les sommets déjà rencontrés (pour ne pas les remettre en file) ; -
une file
en_attente: les sommets découverts mais pas encore visités. On utilise la structure abstraiteFiledu chapitre Structures linéaires :enfiler,defiler,est_vide. Comme au chapitre Arbres, on admet qu’une implémentation existe : seule compte ici l’interface.
def BFS(g, depart):
    """Parcours en largeur de g depuis depart ;
       renvoie la liste des sommets dans l'ordre de visite."""
    traites = []
    decouverts = [depart]
    en_attente = File()             # la file (interface admise)
    en_attente.enfiler(depart)
    while not en_attente.est_vide():
        sommet = en_attente.defiler()       # on defile (FIFO)
        for voisin in g.voisins(sommet):
            if voisin not in decouverts:    # tester AVANT d'enfiler
                decouverts.append(voisin)
                en_attente.enfiler(voisin)  # on enfile
        traites.append(sommet)
    return traites
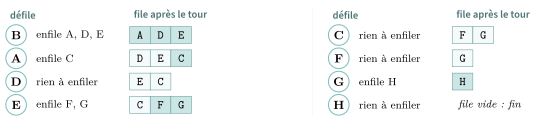
Sur le graphe ci-dessus, BFS(g, ’B’) renvoie [’B’, ’A’, ’D’, ’E’, ’C’, ’F’, ’G’, ’H’] : on visite B, puis ses voisins A, D, E, puis les nouveaux voisins de ceux-ci, etc.
Voici l’état de la file en_attente après chaque tour de boucle (à gauche, le sommet défilé et visité ; la tête de la file est à gauche, les sommets qui viennent d’être enfilés sont foncés) :
Remarque — Pourquoi decouverts ?
Un même sommet peut être le voisin de plusieurs autres. Sans la liste decouverts, on l’enfilerait plusieurs fois. Le test if voisin not in decouverts, fait avant d’enfiler, garantit que chaque sommet n’entre qu’une fois dans la file. Tester seulement traites ne suffirait pas : un sommet déjà en attente (découvert mais pas encore visité) serait enfilé une seconde fois.
Remarque — Et si l’on écrivait la file avec une list ?
On pourrait remplacer File() par une list Python, en enfilant avec append et en défilant avec pop(0). Le parcours serait juste, mais lent sur un grand graphe : chaque pop(0) décale tous les éléments restants et coûte \(O(n)\) (voir le chapitre Structures linéaires). D’où l’intérêt de raisonner avec l’interface File, quitte à choisir ensuite une implémentation efficace (liste chaînée, deux piles).
Application vedette : le plus court chemin#
Le BFS découvre les sommets par distance croissante. Donc, si l’on mémorise le « parent » de chaque sommet (celui qui l’a fait découvrir), on peut ensuite remonter de l’arrivée jusqu’au départ : on obtient un chemin, et — miracle du BFS — c’est le plus court (en nombre d’arêtes).
def plus_court_chemin(g, depart, arrivee):
    """Renvoie un plus court chemin de depart a arrivee (liste de sommets),
       ou None s'il n'y en a pas."""
    decouverts = [depart]
    en_attente = File()
    en_attente.enfiler(depart)
    parent = {depart: None}         # depart n'a pas de parent
    while not en_attente.est_vide():
        sommet = en_attente.defiler()
        if sommet == arrivee:              # arrive : on reconstruit
            chemin = [arrivee]
            while parent[chemin[0]] is not None:
                chemin = [parent[chemin[0]]] + chemin
            return chemin
        for voisin in g.voisins(sommet):
            if voisin not in decouverts:
                decouverts.append(voisin)
                en_attente.enfiler(voisin)
                parent[voisin] = sommet    # on note qui l'a decouvert
    return None
Propriété 4 — Pourquoi c’est le plus court
Le BFS visite tous les sommets à distance \(k\) avant ceux à distance \(k+1\). Si l’arrivée est à distance \(k\) du départ, elle sera donc découverte comme voisine d’un sommet à distance \(k-1\). En remontant les parents, on traverse exactement une « couche » à chaque étape : le chemin obtenu a la longueur minimale \(k\). C’est pour cela que le BFS est au cœur du calcul d’itinéraires sur graphe non pondéré.
Le parcours en profondeur (DFS)#
Ici, on va le plus loin possible avant de faire demi-tour : on visite un voisin, puis son premier voisin, et ainsi de suite jusqu’à l’impasse ; alors on revient au dernier embranchement pour explorer une autre branche. C’est exactement la stratégie « toujours à droite » dans un labyrinthe.
Ce parcours s’écrit naturellement de façon récursive : visiter un sommet, c’est se visiter soi-même puis lancer le parcours sur chaque voisin non encore visité.
def DFS(g, sommet, traites=None):
    if traites is None:
        traites = []
    traites.append(sommet)
    for voisin in g.voisins(sommet):
        if voisin not in traites:
            DFS(g, voisin, traites)
    return traites
Le paramètre traites a la valeur par défaut None, remplacée par une liste neuve au premier appel : c’est la bonne pratique vue au chapitre Récursivité (une valeur par défaut [] serait partagée d’un appel de l’utilisateur à l’autre).
Sur le graphe précédent, DFS(g, ’A’) renvoie [’A’, ’B’, ’D’, ’C’, ’E’, ’F’, ’G’, ’H’] : depuis A on plonge par B, puis D, puis C (impasse), on remonte, puis E, F, G, H.
Version itérative, avec une pile#
Le DFS s’écrit aussi sans récursion, en remplaçant la file du BFS par une pile (structure abstraite Pile, elle aussi admise : empiler, depiler, est_vide) : le dernier sommet empilé repart en premier.
def DFS_iteratif(g, depart):
    traites = []
    en_attente = Pile()                # la pile (interface admise)
    en_attente.empiler(depart)
    while not en_attente.est_vide():
        sommet = en_attente.depiler()  # on depile (LIFO)
        if sommet not in traites:      # deja traite : on l'ignore
            traites.append(sommet)
            for voisin in g.voisins(sommet):
                if voisin not in traites:
                    en_attente.empiler(voisin)  # on empile
    return traites
Sur le graphe précédent, DFS_iteratif(g, ’A’) renvoie [’A’, ’C’, ’D’, ’E’, ’G’, ’H’, ’F’, ’B’] : le dernier voisin empilé ressort le premier, d’où un ordre différent du DFS récursif — mais c’est bien, lui aussi, un parcours en profondeur.
Règle 7 — Où placer le test : file ou pile, ce n’est pas pareil
-
En largeur (file) : on teste
decouvertsavant d’enfiler. Chaque sommet n’entre qu’une fois dans la file, et l’ordre « par couches » est respecté. -
En profondeur itératif (pile) : on fait l’inverse, exprès. Un sommet peut être empilé plusieurs fois (par plusieurs voisins) ; on le marque
traitesseulement quand on le dépile, et on ignore les exemplaires suivants. C’est ce qui garantit que l’on plonge toujours depuis le sommet le plus récent : si l’on marquait les sommets dès l’empilement, le parcours obtenu ne serait plus vraiment « en profondeur » (exemple ci-dessous).
Exemple — Marquer à l’empilement ou au dépilement ?
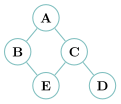
Arêtes A--B, A--C, B--E, C--D, C--E, départ A, voisins pris par ordre alphabétique. Dans le tableau, la pile est écrite en ligne, sommet à droite ; chaque ligne correspond à un sommet dépilé.
| marqué à l’empilement | marqué au dépilement (DFS_iteratif) |
||
|---|---|---|---|
| dépile | pile ensuite | dépile | pile ensuite |
A |
B C (B, C marqués) |
A |
B C |
C |
B D E (D, E marqués) |
C |
B D E |
E |
B D (B déjà marqué) |
E |
B D B (B pas encore traité) |
D |
B |
B |
B D |
B |
(vide) | D |
B |
B |
(vide) : déjà traité, ignoré | ||
ordre : A, C, E, D, B |
ordre : A, C, E, B, D |
||
En marquant dès l’empilement (à gauche), E ne peut pas empiler B, déjà marqué mais jamais visité : on repart de D. Or un vrai parcours en profondeur, arrivé en E, continue vers son voisin B avant de revenir en arrière : c’est l’ordre A, C, E, B, D que donne bien DFS_iteratif (à droite).
À retenir — une file pour la largeur, une pile pour la profondeur
BFS et DFS partagent le même squelette, mais pas la même structure : le BFS range les sommets en attente dans une file (FIFO, premier arrivé, premier sorti), le DFS dans une pile (LIFO, dernier arrivé, premier sorti). Ce seul choix explique leurs comportements opposés : la file sert d’abord les sommets découverts le plus tôt, donc les plus proches du départ (cercles concentriques) ; la pile sert d’abord le dernier découvert, donc on s’enfonce le plus loin possible. Toute la puissance du chapitre Structures linéaires est là : la structure de données choisie dicte le comportement de l’algorithme. Il n’existe pas « un seul » BFS ni « un seul » DFS : ce qui les caractérise est la méthode de découverte, pas l’ordre exact des voisins.
Deux applications directes : chemin et cycle#
-
Existe-t-il un chemin de
uàv? On lance un parcours depuisu; il existe un chemin si et seulement sivfigure dans les sommets visités. (Un parcours depuisuexplore toute la composante connexe deu.) -
Le graphe est-il connexe ? Il l’est si et seulement si un parcours depuis n’importe quel sommet visite tous les sommets.
-
Y a-t-il un cycle ? On le repère aussi au cours d’un parcours… mais le critère n’est pas le même selon que le graphe est orienté ou non : c’est l’objet du paragraphe suivant.
Repérer un cycle : deux critères, selon l’orientation#
Graphe non orienté. Au cours d’un parcours, si l’on retombe sur un sommet déjà découvert qui n’est pas le sommet d’où l’on vient d’arriver (son « parent »), c’est qu’un cycle boucle par là. On exclut le parent parce qu’une arête se lit dans les deux sens : l’arête A -- B fait apparaître A parmi les voisins de B, sans former de cycle pour autant.
Graphe orienté : ce critère est faux. Reprenons le graphe orienté de la partie II (rappelé ci-dessous) et oublions un instant l’arc C\(\to\)A, en pointillés. Un parcours en profondeur depuis A découvre B, C, puis E (par l’arc C\(\to\)E) ; il revient en arrière, explore D, et l’arc D\(\to\)E le fait retomber sur E, déjà découvert, alors qu’il arrive de D. Le critère non orienté crierait au cycle… à tort : B\(\to\)C\(\to\)E et B\(\to\)D\(\to\)E sont deux chemins qui se rejoignent, mais aucun arc ne permet de repartir de E pour revenir en arrière. Même piège dans la recette de l’exercice 14 du chapitre : la tâche (f) est atteinte à la fois depuis (e) et depuis (d), sans le moindre cycle.
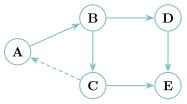
Pour s’en sortir, on distingue, pendant un parcours en profondeur, trois états pour chaque sommet :
-
non vu : le parcours ne l’a pas encore atteint ;
-
en cours : on a commencé à l’explorer, mais pas fini d’explorer ses successeurs. Il est encore dans la pile d’appels : c’est un sommet du chemin qui mène du départ au sommet actuel ;
-
terminé : tous ses successeurs ont été explorés ; on est sorti de son appel.
Règle 8 — Cycle dans un graphe orienté
Au cours d’un parcours en profondeur d’un graphe orienté, il y a un cycle lorsqu’un arc mène à un sommet en cours : on peut alors suivre le chemin en cours jusqu’au sommet actuel, puis revenir au point de départ par cet arc. Un arc qui mène à un sommet terminé ne signale pas de cycle (deux chemins qui se rejoignent).
Exemple — Les deux situations sur le même graphe
Sans l’arc C\(\to\)A. A, B, C passent « en cours », puis E, qui n’a aucun successeur : E est aussitôt « terminé », puis C. On revient à B, qui explore D ; l’arc D\(\to\)E mène à un sommet terminé : pas de cycle. Finalement, tout est terminé : le graphe n’a pas de cycle.
Avec l’arc C\(\to\)A. Quand on explore C, les sommets A, B, C sont « en cours ». L’arc C\(\to\)A mène à un sommet en cours : il y a un cycle, A\(\to\)B\(\to\)C\(\to\)A.
En Python, avec le dictionnaire G des successeurs et un dictionnaire etat (un sommet absent de etat n’a pas encore été vu) :
def cycle_depuis(G, sommet, etat):
    """Parcours en profondeur du graphe oriente G depuis sommet ;
       renvoie True si l'on retombe sur un sommet en cours (cycle)."""
    etat[sommet] = 'en cours'           # sommet entre dans la pile d'appels
    for voisin in G[sommet]:
        if voisin not in etat:          # jamais vu : on plonge
            if cycle_depuis(G, voisin, etat):
                return True
        elif etat[voisin] == 'en cours':
            return True                 # retour sur le chemin en cours : cycle
        # sinon voisin est 'termine' : deja explore, pas de cycle par la
    etat[sommet] = 'termine'            # tous ses successeurs sont explores
    return False

def a_un_cycle(G):
    etat = {}
    for s in G:                         # on relance depuis chaque sommet non vu
        if s not in etat and cycle_depuis(G, s, etat):
            return True
    return False
Sur le graphe orienté ci-dessus :
>>> G = {'A': ['B'], 'B': ['C', 'D'], 'C': ['A', 'E'], 'D': ['E'], 'E': []}
>>> a_un_cycle(G)
True
>>> G['C'] = ['E']                  # on retire l'arc C -> A
>>> a_un_cycle(G)
False
Remarque
Ce critère « sommet en cours » permet enfin de programmer la détection d’interblocage vue au chapitre Processus : le graphe d’attente des processus y est un graphe orienté, et un cycle y signale un interblocage.
au-delà du programme Et pour un graphe pondéré ? Le BFS trouve le plus court chemin en nombre d’arêtes, mais ignore les poids. Pour le plus court chemin en distance (un vrai GPS), on utilise l’algorithme de Dijkstra (1959), qui visite les sommets par coût total croissant à l’aide d’une file de priorité. C’est l’objet du projet proposé en fin de chapitre — mais vous en connaissez déjà l’idée directrice. On le retrouvera au chapitre 9, derrière le protocole de routage OSPF.
▶ Exercices d'application : exercices 9 à 12 (parcours ; chemins, connexité) et 20 (parcours à la main en série) ; pour les cycles orientés, voir aussi l’exercice type bac 14 (questions 4 et 5)
Pour les curieux (facultatif) — Un peu d’histoire… et beaucoup de génie
La théorie des graphes naît avec Euler et les ponts de Königsberg, en 1736 (§ I). Deux siècles plus tard, en 1956, le Néerlandais Edsger Dijkstra cherche un joli exemple pour montrer les capacités d’un nouvel ordinateur. Assis à la terrasse d’un café d’Amsterdam avec sa fiancée, sans papier ni crayon, il conçoit en vingt minutes son fameux algorithme du plus court chemin — publié en 1959 dans un article de trois pages. « L’une des raisons pour lesquelles il est si élégant, dira-t-il, c’est que je l’ai conçu sans stylo. » Aujourd’hui, cet algorithme guide chacun de vos trajets GPS.
Et l’histoire continue : en 1967, le psychologue Stanley Milgram met en évidence le phénomène du « petit monde » — les fameux six degrés de séparation qui relieraient deux humains quelconques. En 1998, deux étudiants, Larry Page et Sergueï Brin, modélisent le Web comme un gigantesque graphe orienté : leur algorithme PageRank deviendra… Google. Des ponts de Königsberg à votre moteur de recherche, c’est la même idée qui travaille : ce qui compte, ce sont les relations.
Pour les curieux (facultatif) — Liens avec d’autres chapitres
-
Ce qu’il réutilise : la file (parcours en largeur) et la pile (parcours en profondeur) de Structures linéaires : piles, files, listes chaînées ; la Récursivité pour le parcours en profondeur ; la classe
Graphe(Programmation orientée objet et paradigmes). -
Déjà croisé : un arbre est un graphe connexe sans cycle (Arbres) ; un cycle dans le graphe d’attente signale un interblocage (Processus et ordonnancement).
-
Pour aller plus loin : l’algorithme de Dijkstra sera au cœur du routage OSPF (Réseaux).
Bilan — la carte mémoire#
| Notion | À retenir |
|---|---|
| Graphe | des sommets reliés par des arêtes (relations) |
| Orienté / non orienté | arcs à sens unique / arêtes à double sens |
| Ordre / taille | nombre de sommets \(n\) / nombre d’arêtes \(m\) |
| Voisins, degré | sommets adjacents ; nombre de voisins |
| Poignées de main | \(\sum \deg(s) = 2m\) (nb. de sommets de degré impair : pair) |
| Chaîne / chemin, cycle | suite de sommets reliés ; qui revient au départ |
| Connexe | « d’un seul tenant » (sinon : composantes connexes) |
| Matrice d’adjacence | tableau \(n\times n\) de \(0/1\) ; mémoire \(O(n^2)\) ; arête en \(O(1)\) |
| Liste d’adjacence | dictionnaire sommet \(\to\) voisins ; mémoire \(O(n+m)\) |
| BFS (largeur) | une file (FIFO), cercles concentriques, plus court chemin |
| DFS (profondeur) | une pile (LIFO, ou la récursivité), « le plus loin d’abord » |
| Mémoriser les visités | obligatoire sur un graphe (cycles !) |
| Cycle, non orienté | retomber sur un sommet déjà découvert, autre que le parent |
| Cycle, orienté | retomber (en profondeur) sur un sommet en cours |
Retour à la situation de départ
-
Par un graphe : des sommets reliés par des arêtes (ou des arcs, s’il est orienté), représenté en Python par une matrice d’adjacence ou une liste d’adjacence, un dictionnaire qui associe à chaque sommet ses voisins (§ I à III).
-
Elle lance un parcours en largeur, avec une file, depuis la station de départ : les sommets sont découverts par distance croissante, et en remontant les « parents » on obtient un plus court chemin en nombre d’arêtes (§ V.B).
-
En mémorisant les sommets déjà découverts : un parcours, en largeur ou en profondeur, visite ainsi chaque sommet une seule fois. Retomber sur un sommet déjà vu (autre que le parent, ou « en cours » s’il est orienté) révèle un cycle (§ V).
Erreurs fréquentes#
-
Oublier de mémoriser les sommets visités. Sur un graphe (contrairement à un arbre), le parcours boucle à l’infini. Le réflexe : une liste
decouverts/traites, toujours. -
Confondre file et pile. File (FIFO) \(=\) BFS \(=\) largeur ; pile (LIFO) \(=\) DFS \(=\) profondeur. Le squelette est le même, c’est la structure qui change tout.
-
Défiler avec
pop(0)sur unelist. Le parcours reste juste, mais chaquepop(0)coûte \(O(n)\) (chapitre Structures linéaires). Le réflexe : raisonner avec l’interfaceFile(enfiler/defiler/est_vide). -
Appliquer à un graphe orienté le critère de cycle du non orienté. Retomber sur un sommet déjà découvert ne prouve rien en orienté (deux chemins peuvent se rejoindre) : il faut retomber sur un sommet en cours.
-
Confondre arête et arc. Non orienté \(\to\) arête (deux sens), matrice symétrique ; orienté \(\to\) arc (un sens).
-
Croire que la matrice est toujours le bon choix. Pour un graphe creux, la liste d’adjacence est bien plus économe (\(O(n+m)\) contre \(O(n^2)\)).
-
Enfiler un sommet déjà en attente (BFS). En largeur, on teste l’appartenance à
decouvertsavant d’enfiler, pas seulement àtraites. (En profondeur itératif, c’est l’inverse : on testetraitesau moment de dépiler, voir le cours.) -
Oublier la double insertion dans
ajoute_areted’un graphe non orienté (il faut ajouterachezbetbcheza).
Savoir-faire à maîtriser#
À la fin du chapitre, je sais…
-
employer le vocabulaire (sommet, arête/arc, voisin, degré, chaîne/chemin, cycle, connexe) \(\to\) ex. 1, 3 ;
-
modéliser une situation concrète par un graphe orienté ou non, pondéré ou non \(\to\) ex. 2, 3, 13 ;
-
écrire une matrice d’adjacence, une liste d’adjacence, et passer de l’une à l’autre \(\to\) ex. 4, 5, 6 ;
-
dérouler et coder un parcours en largeur (file) et en profondeur (pile ou récursif) \(\to\) ex. 9, 10 ;
-
trouver un chemin, un plus court chemin (BFS), tester la connexité \(\to\) ex. 11, 12 ;
-
repérer un cycle, en distinguant graphe non orienté (sommet déjà découvert, autre que le parent) et orienté (sommet en cours) \(\to\) ex. 14.
Vers le Grand Oral#
-
Comment un GPS calcule-t-il le plus court chemin ? (modélisation en graphe pondéré ; BFS pour le nombre d’étapes, Dijkstra pour la distance ; l’anecdote du café d’Amsterdam.)
-
Pourquoi dit-on que nous sommes tous à « six poignées de main » ? (graphe des relations, phénomène du petit monde, distance dans un graphe.)
-
Largeur ou profondeur : comment le choix d’une structure de données change-t-il un algorithme ? (file vs pile ; un même squelette, deux comportements.)
-
En quoi le problème des sept ponts a-t-il fondé une science ? (l’abstraction d’Euler ; modéliser, c’est jeter l’inutile.)